 Promeni jezik
Dodavanje omiljenog sajta s vestima
calibre ima moćan, prilagodljiv i jednostavan sistem za preuzimanje vesti s interneta i njihovo pretvaranje u e-knjigu. Primeri u nastavku pokazuju kako da preuzmete vesti s različitih sajtova.
Da biste razumeli kako se ovaj sistem koristi, pratite primere sledećim redom:
Potpuno automatsko preuzimanje
Ako je izvor vesti dovoljno jednostavan, calibre može sve da preuzme automatski. Potrebno je samo da navedete URL adresu. calibre čuva podatke potrebne za preuzimanje izvora vesti u recipe. Da biste dodali izvor vesti, morate da napravite recipe za njega. Pogledajmo nekoliko primera:
Blog programa calibre
Na blogu programa calibre objavljuju se jednostavna i pristupačna objašnjenja mnogih korisnih mogućnosti programa, namenjena novim korisnicima. Da bismo blog preuzeli kao e-knjigu, koristićemo njegov RSS dovod:
http://blog.calibre-ebook.com/feeds/posts/default
RSS adresu sam pronašao u odeljku „Subscribe to” na dnu stranice bloga, gde sam izabrao Posts → Atom. Da bi calibre preuzeo dovod i pretvorio ga u e-knjigu, kliknite desnim tasterom na dugme Fetch news, zatim izaberite Add a custom news source, pa dugme New Recipe. Otvoriće se dijalog sličan onom prikazanom ispod.
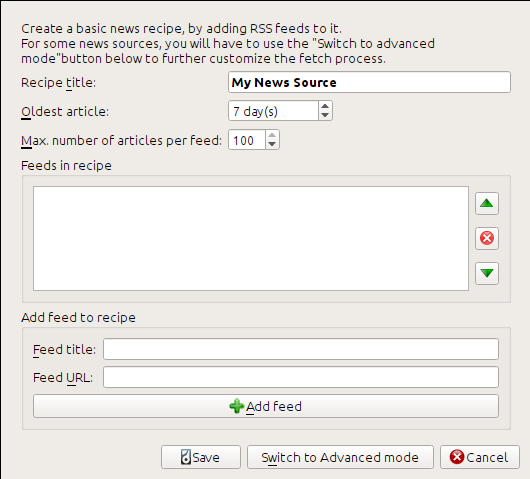
Najpre unesite Calibre Blog u polje Recipe title. To će biti naslov e-knjige nastale od članaka iz navedenog dovoda.
Naredna dva polja (Oldest article i Max. number of articles) omogućavaju da odredite koliko će se članaka preuzeti iz svakog dovoda. Njihova namena je jasna iz naziva.
Da biste dodali dovod u recept, unesite njegov naslov i URL adresu, pa kliknite na Add feed. Kada dodate dovod, kliknite na Save i posao je završen. Zatvorite dijalog.
Da biste isprobali novi recipe, kliknite na Fetch news, pa u podmeniju Custom news sources izaberite calibre Blog. Posle nekoliko minuta nova e-knjiga s objavama sa bloga pojaviće se u glavnom prikazu biblioteke. Ako je čitač povezan, knjiga će umesto toga biti poslata na njega. Izaberite knjigu i kliknite na View da biste je pročitali.
Ovo je uspelo uz malo truda zato što blog nudi RSS dovod s punim sadržajem: tekst članaka nalazi se u samom dovodu. Većina izvora koji na taj način objavljuju vesti može se pretvoriti u e-knjigu bez dodatnog podešavanja. Sada ćemo pogledati izvor koji ne nudi dovod s punim sadržajem. Kod takvih izvora ceo članak nalazi se na veb-stranici, dok dovod sadrži samo link do nje i kratak sažetak.
bbc.co.uk
Isprobajmo sledeća dva dovoda sajta The BBC:
Naslovna strana vesti: https://newsrss.bbc.co.uk/rss/newsonline_world_edition/front_page/rss.xml
Nauka i priroda: https://newsrss.bbc.co.uk/rss/newsonline_world_edition/science/nature/rss.xml
Napravite recept za The BBC od navedenih dovoda, prateći postupak iz odeljka Blog programa calibre. U preuzetoj e-knjizi videćete da je calibre prilično dobro izdvojio bitan sadržaj sa stranice svakog članka. Ipak, izdvajanje nije savršeno: ponekad ostanu nepotrebni elementi, poput menija i navigacije, a ponekad se ukloni nešto što je trebalo sačuvati, poput naslova članaka. Za preciznije izdvajanje sadržaja potrebno je prilagoditi postupak preuzimanja, kao što je opisano u narednom odeljku.
Prilagođavanje postupka preuzimanja
Ako želite da usavršite preuzimanje ili da preuzimate sadržaj sa složenijeg sajta, iskoristite mogućnosti sistema recipe. U dijalogu Add custom news sources kliknite na dugme Switch to Advanced mode.
Najjednostavnije, a često i najkorisnije prilagođavanje jeste korišćenje verzije članka za štampu. Ona obično sadrži manje suvišnih elemenata i lakše se pretvara u e-knjigu. Isprobajmo je na člancima sajta The BBC.
Korišćenje verzije za štampu sa sajta bbc.co.uk
Najpre pogledajte e-knjigu koju smo ranije preuzeli u odeljku bbc.co.uk. Na kraju svakog članka u knjizi nalazi se kratka napomena s adresom sa koje je članak preuzet. Kopirajte taj URL i otvorite ga u pregledaču. Na stranici članka potražite link „Printable version” i kliknite na njega. Verzija za štampu izgleda mnogo urednije. Uporedite dve adrese. U mom slučaju bile su sledeće:
Izgleda da za dobijanje verzije za štampu svakoj adresi članka treba dodati sledeći prefiks:
newsvote.bbc.co.uk/mpapps/pagetools/print/
U Advanced mode dijaloga za prilagođene izvore vesti trebalo bi da vidite nešto poput sledećeg (ne zaboravite da pre prelaska u napredni režim izaberete recept The BBC):
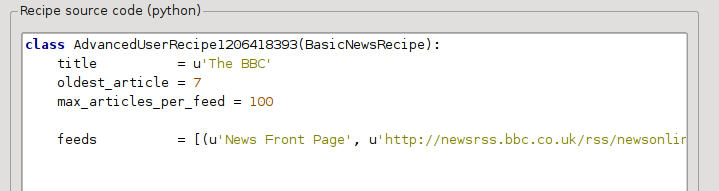
Polja iz Basic mode jednostavno su pretvorena u Python kod. Receptu treba da dodamo uputstva za korišćenje verzije članaka za štampu. Dovoljno je dodati sledeća dva reda:
def print_version(self, url):
    return url.replace('https://', 'https://newsvote.bbc.co.uk/mpapps/pagetools/print/')
Ovo je Python, pa je uvlačenje redova važno. Kada dodate redove, kod treba da izgleda ovako:
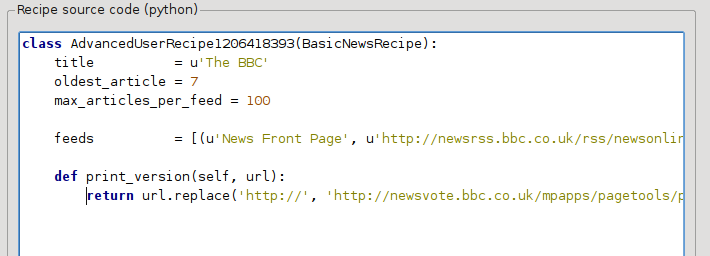
U gornjem primeru def print_version(self, url) definiše metod koji calibre poziva za svaki članak. url je adresa izvornog članka. Metod print_version zamenjuje tu adresu novom, koja vodi do verzije članka za štampu. Više o jeziku Python potražite u uputstvu.
Kliknite na Add/update recipe da sačuvate izmene, pa ponovo preuzmite e-knjigu. Rezultat bi trebalo da bude znatno bolji. Jedan preostali problem jeste premali font na veb-stranici verzije za štampu. Pri pretvaranju u e-knjigu to se automatski ispravlja, ali font menija i navigacije tada može postati prevelik u odnosu na tekst članka. To ćemo rešiti dodatnim prilagođavanjem u narednom odeljku.
Zamena stilova članaka
U prethodnom odeljku videli smo da je font članaka u verziji sajta The BBC za štampu premali. Na većini sajtova, uključujući The BBC, veličina fonta određena je listovima stilova CSS. Njihovo preuzimanje možemo isključiti dodavanjem sledećeg reda:
no_stylesheets = True
Recept sada izgleda ovako:
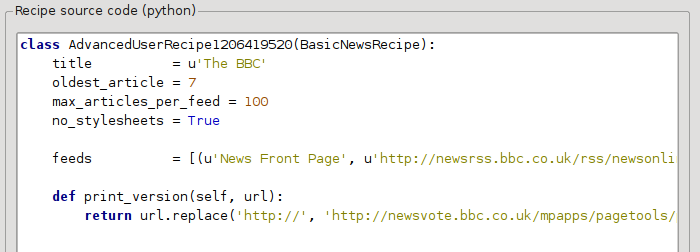
Nova verzija izgleda prilično dobro. Ako želite da je dodatno doterate, pročitajte naredni odeljak o izmeni preuzetog sadržaja.
Izdvajanje i preuređivanje sadržaja
calibre pruža moćne i prilagodljive načine za obradu preuzetog sadržaja. Da bismo pokazali neke od njih, vratimo se receptu The BBC. Kada pogledamo izvorni kod (HTML) nekoliko članaka u verziji za štampu, videćemo da imaju podnožje bez korisnih informacija, sadržano u
<div class="footer">
...
</div>
To se može ukloniti dodavanjem sledećeg:
remove_tags = [dict(name='div', attrs={'class':'footer'})]
Na kraju, deo CSS stilova čije smo preuzimanje ranije isključili zamenićemo sopstvenim CSS stilovima pogodnim za pretvaranje u e-knjigu:
extra_css = '.headline {font-size: x-large;} \n .fact { padding-top: 10pt }'
Uz ove dodatke naš recept je spreman za redovnu upotrebu.
Ovaj recipe pokazuje samo mali deo mogućnosti programa calibre. U narednom odeljku istražićemo još mogućnosti na složenijem primeru iz prakse.
Primer iz prakse
Dobar, nešto složeniji primer koji prikazuje više mogućnosti API interfejsa klase BasicNewsRecipe jeste recipe za The New York Times.
import string, re
from calibre import strftime
from calibre.web.feeds.recipes import BasicNewsRecipe
from calibre.ebooks.BeautifulSoup import BeautifulSoup

class NYTimes(BasicNewsRecipe):

    title       = 'The New York Times'
    __author__  = 'Kovid Goyal'
    description = 'Daily news from the New York Times'
    timefmt = ' [%a, %d %b, %Y]'
    needs_subscription = True
    remove_tags_before = dict(id='article')
    remove_tags_after  = dict(id='article')
    remove_tags = [dict(attrs={'class':['articleTools', 'post-tools', 'side_tool', 'nextArticleLink clearfix']}),
                dict(id=['footer', 'toolsRight', 'articleInline', 'navigation', 'archive', 'side_search', 'blog_sidebar', 'side_tool', 'side_index']),
                dict(name=['script', 'noscript', 'style'])]
    encoding = 'cp1252'
    no_stylesheets = True
    extra_css = 'h1 {font: sans-serif large;}\n.byline {font:monospace;}'

    def get_browser(self):
        br = BasicNewsRecipe.get_browser(self)
        if self.username is not None and self.password is not None:
            br.open('https://www.nytimes.com/auth/login')
            br.select_form(name='login')
            br['USERID']   = self.username
            br['PASSWORD'] = self.password
            br.submit()
        return br

    def parse_index(self):
        soup = self.index_to_soup('https://www.nytimes.com/pages/todayspaper/index.html')

        def feed_title(div):
            return ''.join(div.findAll(text=True, recursive=False)).strip()

        articles = {}
        key = None
        ans = []
        for div in soup.findAll(True,
             attrs={'class':['section-headline', 'story', 'story headline']}):

             if ''.join(div['class']) == 'section-headline':
                 key = string.capwords(feed_title(div))
                 articles[key] = []
                 ans.append(key)

             elif ''.join(div['class']) in ['story', 'story headline']:
                 a = div.find('a', href=True)
                 if not a:
                     continue
                 url = re.sub(r'\?.*', '', a['href'])
                 url += '?pagewanted=all'
                 title = self.tag_to_string(a, use_alt=True).strip()
                 description = ''
                 pubdate = strftime('%a, %d %b')
                 summary = div.find(True, attrs={'class':'summary'})
                 if summary:
                     description = self.tag_to_string(summary, use_alt=False)

                 feed = key if key is not None else 'Uncategorized'
                 if feed not in articles:
                     articles[feed] = []
                 if not 'podcasts' in url:
                     articles[feed].append(
                               dict(title=title, url=url, date=pubdate,
                                    description=description,
                                    content=''))
        ans = self.sort_index_by(ans, {'The Front Page':-1, 'Dining In, Dining Out':1, 'Obituaries':2})
        ans = [(key, articles[key]) for key in ans if key in articles]
        return ans

    def preprocess_html(self, soup):
        refresh = soup.find('meta', {'http-equiv':'refresh'})
        if refresh is None:
            return soup
        content = refresh.get('content').partition('=')[2]
        raw = self.browser.open('https://www.nytimes.com'+content).read()
        return BeautifulSoup(raw.decode('cp1252', 'replace'))
U ovom recipe pojavljuje se nekoliko novih mogućnosti. Najpre imamo:
timefmt = ' [%a, %d %b, %Y]'
Ovo određuje da se datum na naslovnoj strani napravljene e-knjige prikaže u formatu Day, Day_Number Month, Year. Pogledajte timefmt.
Zatim sledi grupa uputstava za čišćenje preuzetog HTML sadržaja:
remove_tags_before = dict(name='h1')
remove_tags_after  = dict(id='footer')
remove_tags = ...
Ona uklanjaju sve pre prve oznake <h1> i sve posle prve oznake čiji je identifikator footer. Pogledajte remove_tags, remove_tags_before i remove_tags_after.
Sledeća zanimljiva mogućnost jeste:
needs_subscription = True
...
def get_browser(self):
    ...
needs_subscription = True govori programu calibre da su za pristup sadržaju ovog recepta potrebni korisničko ime i lozinka. Zato će ih calibre zatražiti svaki put kada pokušate da koristite recept. Kod u metodu calibre.web.feeds.news.BasicNewsRecipe.get_browser() prijavljuje se na sajt NYT-a. Posle prijavljivanja calibre koristi istu prijavljenu instancu pregledača za preuzimanje celog sadržaja. Da biste razumeli taj kod, pogledajte mechanize i get_browser.
Sledeća nova mogućnost je metod calibre.web.feeds.news.BasicNewsRecipe.parse_index(). On otvara https://www.nytimes.com/pages/todayspaper/index.html i preuzima spisak članaka iz današnjeg izdanja. Iako je složeniji od korišćenja RSS dovoda, recept pravi e-knjigu koja veoma verno odgovara dnevnom izdanju. parse_index u velikoj meri koristi BeautifulSoup za obradu veb-stranice. Ako vam BeautifulSoup ne odgovara, možete koristiti i druge, savremenije parsere. Uz calibre dolaze lxml i html5lib, koji se preporučuju. Da biste ih koristili, zamenite poziv index_to_soup() sledećim:
raw = self.index_to_soup(url, raw=True)
# For html5lib
import html5lib
root = html5lib.parse(raw, namespaceHTMLElements=False, treebuilder='lxml')
# For the lxml html 4 parser
from lxml import html
root = html.fromstring(raw)
Poslednja nova mogućnost je metod calibre.web.feeds.news.BasicNewsRecipe.preprocess_html(). Njime možete proizvoljno izmeniti svaku preuzetu HTML stranicu. Ovde se koristi za zaobilaženje reklama koje nytimes prikazuje pre svakog članka.
Saveti za pravljenje novih recepata
Nove recepte je najbolje razvijati pomoću interfejsa komandne linije. Napravite recept u omiljenom Python uređivaču i sačuvajte ga, na primer, u fajlu myrecipe.recipe. Nastavak .recipe je obavezan. Sadržaj pomoću tog recepta možete preuzeti sledećom komandom:
ebook-convert myrecipe.recipe .epub --test -vv --debug-pipeline debug
Komanda ebook-convert preuzeće sve veb-stranice i sačuvati ih u EPUB fajlu myrecipe.epub. Opcija -vv nalaže programu ebook-convert da prikaže opširne podatke o svom radu. Opcija ebook-convert-recipe-input --test ograničava preuzimanje na nekoliko članaka iz najviše dva dovoda. Pored toga, ebook-convert će preuzeti HTML sadržaj i sačuvati ga u fascikli debug/input, gde je debug fascikla koju ste naveli opcijom ebook-convert --debug-pipeline.
Kada se preuzimanje završi, preuzeti HTML možete pregledati otvaranjem fajla debug/input/index.html u pregledaču. Kada se uverite da preuzimanje i prethodna obrada rade ispravno, možete napraviti e-knjige u različitim formatima kao što je prikazano ispod:
ebook-convert myrecipe.recipe myrecipe.epub
ebook-convert myrecipe.recipe myrecipe.mobi
...
Ako ste zadovoljni receptom i smatrate da bi bio koristan i drugima, objavite ga na forumu za calibre recepte i podelite s drugim korisnicima.
Белешка
Na macOS-u se alati komandne linije nalaze u programskom paketu calibre. Na primer, ako ste calibre instalirali u /Applications, alati se nalaze u /Applications/calibre.app/Contents/MacOS/.
See also
- ebook-convert
Interfejs komandne linije za pretvaranje e-knjiga u različite formate.
Dodatna literatura
Ako želite da naučite više o pisanju naprednih recepata pomoću mogućnosti klase BasicNewsRecipe, pogledajte sledeće izvore:
- API dokumentacija
Dokumentacija klase
BasicNewsRecipei njenih važnih metoda i polja.- BasicNewsRecipe
Izvorni kod klase
BasicNewsRecipe- Ugrađeni recepti
Izvorni kod ugrađenih recepata koji dolaze uz calibre
- Forum za calibre recepte
Ovde možete razgovarati s mnogim iskusnim autorima recepata za calibre.
API dokumentacija
- API dokumentacija za recepte
BasicNewsRecipeBasicNewsRecipe.adeify_images()BasicNewsRecipe.image_url_processor()BasicNewsRecipe.print_version()BasicNewsRecipe.tag_to_string()BasicNewsRecipe.abort_article()BasicNewsRecipe.abort_recipe_processing()BasicNewsRecipe.add_toc_thumbnail()BasicNewsRecipe.canonicalize_internal_url()BasicNewsRecipe.cleanup()BasicNewsRecipe.clone_browser()BasicNewsRecipe.default_cover()BasicNewsRecipe.download()BasicNewsRecipe.extract_readable_article()BasicNewsRecipe.get_article_url()BasicNewsRecipe.get_browser()BasicNewsRecipe.get_cover_url()BasicNewsRecipe.get_extra_css()BasicNewsRecipe.get_feeds()BasicNewsRecipe.get_masthead_title()BasicNewsRecipe.get_masthead_url()BasicNewsRecipe.get_obfuscated_article()BasicNewsRecipe.get_url_specific_delay()BasicNewsRecipe.index_to_soup()BasicNewsRecipe.is_link_wanted()BasicNewsRecipe.parse_feeds()BasicNewsRecipe.parse_index()BasicNewsRecipe.populate_article_metadata()BasicNewsRecipe.postprocess_book()BasicNewsRecipe.postprocess_html()BasicNewsRecipe.preprocess_html()BasicNewsRecipe.preprocess_image()BasicNewsRecipe.preprocess_raw_html()BasicNewsRecipe.publication_date()BasicNewsRecipe.skip_ad_pages()BasicNewsRecipe.sort_index_by()BasicNewsRecipe.warmup_excluded_domains()BasicNewsRecipe.articles_are_obfuscatedBasicNewsRecipe.auto_cleanupBasicNewsRecipe.auto_cleanup_keepBasicNewsRecipe.browser_typeBasicNewsRecipe.center_navbarBasicNewsRecipe.compress_news_imagesBasicNewsRecipe.compress_news_images_auto_sizeBasicNewsRecipe.compress_news_images_max_sizeBasicNewsRecipe.conversion_optionsBasicNewsRecipe.cover_marginsBasicNewsRecipe.delayBasicNewsRecipe.descriptionBasicNewsRecipe.encodingBasicNewsRecipe.extra_cssBasicNewsRecipe.feedsBasicNewsRecipe.filter_regexpsBasicNewsRecipe.handle_gzipBasicNewsRecipe.ignore_duplicate_articlesBasicNewsRecipe.keep_only_tagsBasicNewsRecipe.languageBasicNewsRecipe.masthead_urlBasicNewsRecipe.match_regexpsBasicNewsRecipe.max_articles_per_feedBasicNewsRecipe.needs_subscriptionBasicNewsRecipe.no_stylesheetsBasicNewsRecipe.oldest_articleBasicNewsRecipe.preprocess_regexpsBasicNewsRecipe.publication_typeBasicNewsRecipe.recipe_disabledBasicNewsRecipe.recipe_specific_optionsBasicNewsRecipe.recursionsBasicNewsRecipe.remove_attributesBasicNewsRecipe.remove_empty_feedsBasicNewsRecipe.remove_javascriptBasicNewsRecipe.remove_tagsBasicNewsRecipe.remove_tags_afterBasicNewsRecipe.remove_tags_beforeBasicNewsRecipe.requires_versionBasicNewsRecipe.resolve_internal_linksBasicNewsRecipe.reverse_article_orderBasicNewsRecipe.scale_news_imagesBasicNewsRecipe.scale_news_images_to_deviceBasicNewsRecipe.simultaneous_downloadsBasicNewsRecipe.summary_lengthBasicNewsRecipe.template_cssBasicNewsRecipe.timefmtBasicNewsRecipe.timeoutBasicNewsRecipe.titleBasicNewsRecipe.use_embedded_content