 Zmeniť jazyk
Pridanie obľúbenej webovej stránky so správami
calibre má výkonný, flexibilný a ľahko použiteľný rámec na sťahovanie správ z internetu a ich konverziu na e-knihu. Nasledujúce príklady vám ukážu, ako získavať správy z rôznych webových stránok.
Ak chcete pochopiť, ako používať tento rámec, postupujte podľa príkladov v poradí uvedenom nižšie:
Úplne automatické načítavanie
Ak je váš zdroj správ dostatočne jednoduchý, calibre ho možno dokáže načítať úplne automaticky; všetko, čo musíte urobiť, je poskytnúť URL. calibre zhromažďuje všetky informácie potrebné na stiahnutie zdroja správ do receptu. Aby ste calibre povedali o zdroji správ, musíte preň vytvoriť recept. Pozrime sa na niekoľko príkladov:
Blog calibre
Blog calibre je blog s príspevkami, ktoré jednoduchým a zrozumiteľným spôsobom opisujú mnohé užitočné funkcie calibre pre nových používateľov calibre. Aby sme tento blog stiahli do e-knihy, spoliehame sa na RSS kanál blogu:
http://blog.calibre-ebook.com/feeds/posts/default
URL adresu RSS som získal tak, že som sa pozrel pod „Subscribe to“ v spodnej časti stránky blogu a vybral Posts → Atom. Aby calibre stiahlo kanály a skonvertovalo ich na e-knihu, kliknite pravým tlačidlom na tlačidlo Načítať správy, potom na položku ponuky Pridať vlastný zdroj správ a nakoniec na tlačidlo Nový recept. Malo by sa otvoriť dialógové okno podobné tomu, ktoré je znázornené nižšie.
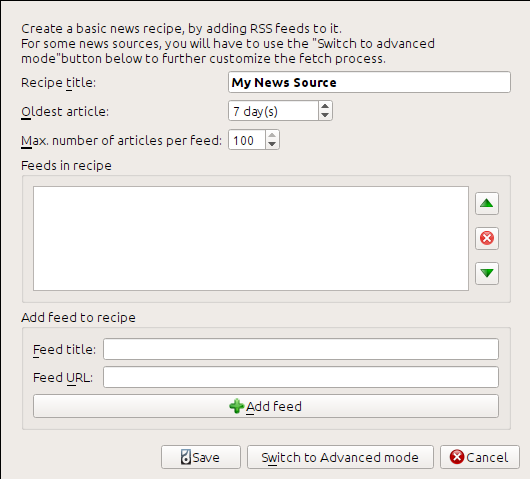
Najprv zadajte Calibre Blog do poľa Názov receptu. Toto bude názov e-knihy, ktorá sa vytvorí z článkov vo vyššie uvedených kanáloch.
Nasledujúce dve polia (Najstarší článok a Maximálny počet článkov) vám umožňujú určitú kontrolu nad tým, koľko článkov sa má stiahnuť z každého kanála, a ich názvy sú pomerne samovysvetľujúce.
Ak chcete pridať kanály do receptu, zadajte názov kanála a URL kanála a kliknite na tlačidlo Pridať kanál. Keď ste kanál pridali, jednoducho kliknite na tlačidlo Uložiť a máte hotovo! Zatvorte dialógové okno.
Ak chcete otestovať svoj nový recept, kliknite na tlačidlo Načítať správy a v podponuke Vlastné zdroje správ kliknite na Blog calibre. Po niekoľkých minútach sa v hlavnom zobrazení knižnice objaví novo stiahnutá e-kniha s príspevkami blogu (ak máte pripojenú čítačku, namiesto do knižnice sa uloží do čítačky). Vyberte ju a stlačte tlačidlo Zobraziť a čítajte!
Dôvod, prečo to fungovalo tak dobre a s tak malým úsilím, je ten, že blog poskytuje RSS kanály s plným obsahom, t. j. obsah článku je vložený priamo v kanáli. Pre väčšinu zdrojov správ, ktoré poskytujú správy týmto spôsobom, s kanálmi s plným obsahom, nepotrebujete na ich konverziu na e-knihy žiadne ďalšie úsilie. Teraz sa pozrieme na zdroj správ, ktorý neposkytuje kanály s plným obsahom. V takýchto kanáloch je celý článok webová stránka a kanál obsahuje iba odkaz na túto webovú stránku s krátkym zhrnutím článku.
bbc.co.uk
Vyskúšajme nasledujúce dva kanály z The BBC:
Postupujte podľa postupu uvedeného vyššie v Blog calibre a vytvorte recept pre The BBC (pomocou vyššie uvedených kanálov). Pri pohľade na stiahnutú e-knihu vidíme, že calibre odviedlo chvályhodnú prácu pri extrahovaní iba obsahu, ktorý vás zaujíma, z webovej stránky každého článku. Proces extrakcie však nie je dokonalý. Niekedy ponecháva nežiaduci obsah, ako ponuky a navigačné prvky, alebo odstraňuje obsah, ktorý mal zostať nedotknutý, ako napríklad nadpisy článkov. Aby sme dosiahli dokonalú extrakciu obsahu, budeme musieť prispôsobiť proces načítavania, ako je opísané v ďalšej sekcii.
Prispôsobenie procesu načítavania
Ak chcete zdokonaliť proces sťahovania alebo stiahnuť obsah z obzvlášť zložitej webovej stránky, môžete využiť všetku silu a flexibilitu rámca receptov. Ak to chcete urobiť, v dialógovom okne Pridať vlastné zdroje správ jednoducho kliknite na tlačidlo Prepnúť do pokročilého režimu.
Najjednoduchšie a často najproduktívnejšie prispôsobenie je použitie tlačenej verzie online článkov. Tlačená verzia má zvyčajne oveľa menej balastu a prevádza sa do e-knihy oveľa plynulejšie. Skúsme použiť tlačenú verziu článkov z The BBC.
Použitie tlačenej verzie bbc.co.uk
Prvým krokom je pozrieť sa na e-knihu, ktorú sme predtým stiahli z bbc.co.uk. Na konci každého článku v e-knihe je malý text, ktorý vám hovorí, odkiaľ bol článok stiahnutý. Skopírujte túto URL adresu a vložte ju do prehliadača. Teraz na webovej stránke článku nájdite odkaz, ktorý ukazuje na „Printable version“ (Verzia na tlač). Kliknutím naň zobrazíte tlačenú verziu článku. Vyzerá to oveľa upratanejšie! Teraz porovnajte tieto dve URL adresy. U mňa to boli:
- URL adresa článku
- URL adresa tlačenej verzie
https://newsvote.bbc.co.uk/mpapps/pagetools/print/news.bbc.co.uk/2/hi/science/nature/7312016.stm
Takže to vyzerá, že na získanie tlačenej verzie musíme pred každú URL adresu článku pridať predponu:
newsvote.bbc.co.uk/mpapps/pagetools/print/
Teraz by ste v Pokročilom režime dialógového okna Vlastné zdroje správ mali vidieť niečo ako (nezabudnite vybrať recept The BBC pred prepnutím do pokročilého režimu):
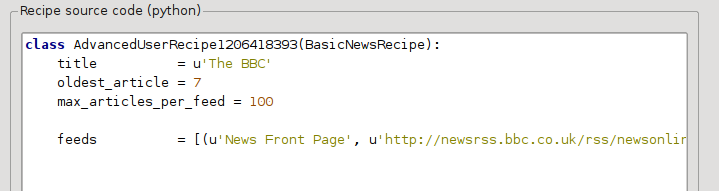
Môžete vidieť, že polia z Základného režimu boli preložené do kódu Pythonu priamočiarym spôsobom. Do tohto receptu musíme pridať pokyny na použitie tlačenej verzie článkov. Všetko, čo je potrebné, je pridať nasledujúce dva riadky:
def print_version(self, url):
    return url.replace('https://', 'https://newsvote.bbc.co.uk/mpapps/pagetools/print/')
Toto je Python, takže odsadenie je dôležité. Po pridaní riadkov by to malo vyzerať takto:
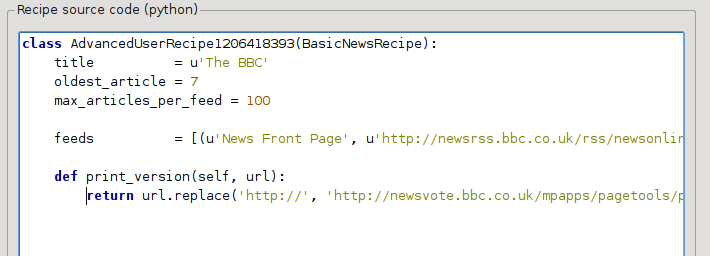
Vyššie def print_version(self, url) definuje metódu, ktorú calibre volá pre každý článok. url je URL adresa pôvodného článku. Funkcia print_version vezme túto URL adresu a nahradí ju novou URL adresou, ktorá ukazuje na tlačenú verziu článku. Ak sa chcete dozvedieť o Pythone, pozrite si tutoriál.
Teraz kliknite na tlačidlo Pridať/aktualizovať recept a vaše zmeny sa uložia. Znova stiahnite e-knihu. Mali by ste mať oveľa lepšiu e-knihu. Jedným z problémov novej verzie je, že písma na webovej stránke tlačenej verzie sú príliš malé. Toto sa automaticky opraví pri konverzii na e-knihu, ale aj po oprave je veľkosť písma ponúk a navigačnej lišty príliš veľká v pomere k textu článku. Aby sme to opravili, vykonáme v ďalšej sekcii ďalšie prispôsobenie.
Nahradenie štýlov článkov
V predchádzajúcej sekcii sme videli, že veľkosť písma pre články z tlačenej verzie The BBC bola príliš malá. Na väčšine webových stránok vrátane The BBC je táto veľkosť písma nastavená pomocou CSS štýlov. Načítavanie takýchto štýlov môžeme zakázať pridaním riadku:
no_stylesheets = True
Recept teraz vyzerá takto:
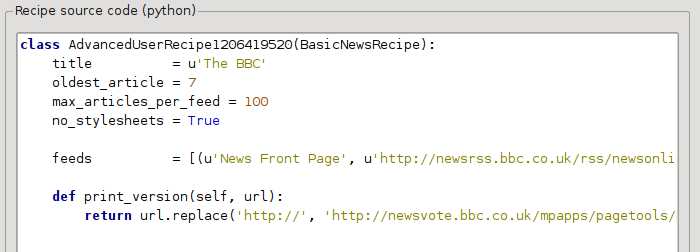
Nová verzia vyzerá celkom dobre. Ak ste perfekcionista, budete si chcieť prečítať ďalšiu sekciu, ktorá sa zaoberá skutočnou úpravou stiahnutého obsahu.
Krájanie a dávkovanie
calibre obsahuje veľmi výkonné a flexibilné schopnosti, pokiaľ ide o manipuláciu so stiahnutým obsahom. Aby sme predviedli niekoľko z nich, pozrime sa znova na náš starý známy recept The BBC. Pri pohľade na zdrojový kód (HTML) niekoľkých článkov (tlačená verzia) vidíme, že majú pätu, ktorá neobsahuje žiadne užitočné informácie, obsiahnutú v
<div class="footer">
...
</div>
Toto možno odstrániť pridaním:
remove_tags = [dict(name='div', attrs={'class':'footer'})]
do receptu. Nakoniec nahraďme časť CSS, ktoré sme predtým zakázali, naším vlastným CSS, ktoré je vhodné na konverziu na e-knihu:
extra_css = '.headline {font-size: x-large;} \n .fact { padding-top: 10pt }'
S týmito dodatkami sa náš recept stal „produkčnej kvality“.
Tento recept skúma iba špičku ľadovca, pokiaľ ide o silu calibre. Aby sme preskúmali viac schopností calibre, pozrieme sa v ďalšej sekcii na zložitejší príklad z praxe.
Príklad z praxe
Pomerne zložitý príklad z praxe, ktorý odhaľuje viac z API triedy BasicNewsRecipe, je recept pre The New York Times
import string, re
from calibre import strftime
from calibre.web.feeds.recipes import BasicNewsRecipe
from calibre.ebooks.BeautifulSoup import BeautifulSoup

class NYTimes(BasicNewsRecipe):

    title       = 'The New York Times'
    __author__  = 'Kovid Goyal'
    description = 'Daily news from the New York Times'
    timefmt = ' [%a, %d %b, %Y]'
    needs_subscription = True
    remove_tags_before = dict(id='article')
    remove_tags_after  = dict(id='article')
    remove_tags = [dict(attrs={'class':['articleTools', 'post-tools', 'side_tool', 'nextArticleLink clearfix']}),
                dict(id=['footer', 'toolsRight', 'articleInline', 'navigation', 'archive', 'side_search', 'blog_sidebar', 'side_tool', 'side_index']),
                dict(name=['script', 'noscript', 'style'])]
    encoding = 'cp1252'
    no_stylesheets = True
    extra_css = 'h1 {font: sans-serif large;}\n.byline {font:monospace;}'

    def get_browser(self):
        br = BasicNewsRecipe.get_browser(self)
        if self.username is not None and self.password is not None:
            br.open('https://www.nytimes.com/auth/login')
            br.select_form(name='login')
            br['USERID']   = self.username
            br['PASSWORD'] = self.password
            br.submit()
        return br

    def parse_index(self):
        soup = self.index_to_soup('https://www.nytimes.com/pages/todayspaper/index.html')

        def feed_title(div):
            return ''.join(div.findAll(text=True, recursive=False)).strip()

        articles = {}
        key = None
        ans = []
        for div in soup.findAll(True,
             attrs={'class':['section-headline', 'story', 'story headline']}):

             if ''.join(div['class']) == 'section-headline':
                 key = string.capwords(feed_title(div))
                 articles[key] = []
                 ans.append(key)

             elif ''.join(div['class']) in ['story', 'story headline']:
                 a = div.find('a', href=True)
                 if not a:
                     continue
                 url = re.sub(r'\?.*', '', a['href'])
                 url += '?pagewanted=all'
                 title = self.tag_to_string(a, use_alt=True).strip()
                 description = ''
                 pubdate = strftime('%a, %d %b')
                 summary = div.find(True, attrs={'class':'summary'})
                 if summary:
                     description = self.tag_to_string(summary, use_alt=False)

                 feed = key if key is not None else 'Uncategorized'
                 if feed not in articles:
                     articles[feed] = []
                 if not 'podcasts' in url:
                     articles[feed].append(
                               dict(title=title, url=url, date=pubdate,
                                    description=description,
                                    content=''))
        ans = self.sort_index_by(ans, {'The Front Page':-1, 'Dining In, Dining Out':1, 'Obituaries':2})
        ans = [(key, articles[key]) for key in ans if key in articles]
        return ans

    def preprocess_html(self, soup):
        refresh = soup.find('meta', {'http-equiv':'refresh'})
        if refresh is None:
            return soup
        content = refresh.get('content').partition('=')[2]
        raw = self.browser.open('https://www.nytimes.com'+content).read()
        return BeautifulSoup(raw.decode('cp1252', 'replace'))
V tomto recepte vidíme niekoľko nových funkcií. Najprv máme:
timefmt = ' [%a, %d %b, %Y]'
Toto nastaví zobrazovaný čas na titulnej stránke vytvorenej e-knihy vo formáte Day, Day_Number Month, Year. Pozri timefmt.
Potom vidíme skupinu direktív na vyčistenie stiahnutého HTML:
remove_tags_before = dict(name='h1')
remove_tags_after  = dict(id='footer')
remove_tags = ...
Tieto odstránia všetko pred prvou značkou <h1> a všetko za prvou značkou, ktorej id je footer. Pozri remove_tags, remove_tags_before, remove_tags_after.
Ďalšou zaujímavou funkciou je:
needs_subscription = True
...
def get_browser(self):
    ...
needs_subscription = True hovorí calibre, že tento recept vyžaduje používateľské meno a heslo na prístup k obsahu. To spôsobí, že calibre sa opýta na používateľské meno a heslo vždy, keď sa pokúsite použiť tento recept. Kód v calibre.web.feeds.news.BasicNewsRecipe.get_browser() v skutočnosti vykonáva prihlásenie na webovú stránku NYT. Po prihlásení bude calibre používať rovnakú prihlásenú inštanciu prehliadača na načítanie celého obsahu. Ak chcete porozumieť kódu v get_browser, pozrite si mechanize.
Ďalšou novou funkciou je metóda calibre.web.feeds.news.BasicNewsRecipe.parse_index(). Jej úlohou je prejsť na https://www.nytimes.com/pages/todayspaper/index.html a načítať zoznam článkov, ktoré sa objavujú v dnešných novinách. Aj keď je zložitejší než jednoduché použitie RSS, recept vytvára e-knihu, ktorá veľmi tesne zodpovedá dnešným novinám. parse_index vo veľkej miere využíva BeautifulSoup na analýzu webovej stránky denných novín. Ak nemáte radi BeautifulSoup, môžete použiť aj iné, modernejšie parsery. calibre sa dodáva s lxml a html5lib, ktoré sú odporúčanými parsermi. Ak ich chcete použiť, nahraďte volanie index_to_soup() nasledujúcim:
raw = self.index_to_soup(url, raw=True)
# For html5lib
import html5lib
root = html5lib.parse(raw, namespaceHTMLElements=False, treebuilder='lxml')
# For the lxml html 4 parser
from lxml import html
root = html.fromstring(raw)
Poslednou novou funkciou je metóda calibre.web.feeds.news.BasicNewsRecipe.preprocess_html(). Možno ju použiť na vykonávanie ľubovoľných transformácií na každej stiahnutej HTML stránke. Tu sa používa na obídenie reklám, ktoré vám nytimes zobrazuje pred každým článkom.
Tipy na vývoj nových receptov
Najlepší spôsob, ako vyvíjať nové recepty, je použiť rozhranie príkazového riadka. Vytvorte recept pomocou svojho obľúbeného editora Pythonu a uložte ho do súboru, napríklad myrecipe.recipe. Prípona .recipe je povinná. Obsah môžete stiahnuť pomocou tohto receptu príkazom:
ebook-convert myrecipe.recipe .epub --test -vv --debug-pipeline debug
Príkaz ebook-convert stiahne všetky webové stránky a uloží ich do súboru EPUB myrecipe.epub. Voľba -vv spôsobí, že ebook-convert vypíše veľa informácií o tom, čo robí. Voľba ebook-convert-recipe-input --test spôsobí, že sa stiahne iba niekoľko článkov z maximálne dvoch kanálov. Okrem toho ebook-convert umiestni stiahnutý HTML do priečinka debug/input, kde debug je priečinok, ktorý ste určili vo voľbe ebook-convert --debug-pipeline.
Po dokončení sťahovania si môžete stiahnutý HTML pozrieť otvorením súboru debug/input/index.html v prehliadači. Keď ste presvedčení, že sťahovanie a predspracovanie prebieha správne, môžete generovať e-knihy v rôznych formátoch, ako je uvedené nižšie:
ebook-convert myrecipe.recipe myrecipe.epub
ebook-convert myrecipe.recipe myrecipe.mobi
...
Ak ste s receptom spokojní a cítite, že je dostatočný dopyt na to, aby odôvodnil jeho zaradenie do sady vstavaných receptov, uverejnite svoj recept na fóre receptov calibre a podelíte sa o neho s ostatnými používateľmi calibre.
Poznámka
V macOS sú nástroje príkazového riadka vnútri balíka calibre; napríklad ak ste calibre nainštalovali do /Applications, nástroje príkazového riadka sú v /Applications/calibre.app/Contents/MacOS/.
Viď aj
- ebook-convert
Rozhranie príkazového riadka pre všetky konverzie e-kníh.
Ďalšie čítanie
Ak sa chcete dozvedieť viac o písaní pokročilých receptov pomocou niektorých nástrojov dostupných v BasicNewsRecipe, mali by ste si pozrieť tieto zdroje:
- Dokumentácia API
Dokumentácia triedy
BasicNewsRecipea všetkých jej dôležitých metód a polí.- BasicNewsRecipe
Zdrojový kód
BasicNewsRecipe- Vstavané recepty
Zdrojový kód vstavaných receptov, ktoré sú súčasťou calibre
- Fórum receptov calibre
Stretáva sa tu veľa skúsených tvorcov receptov pre calibre.
Dokumentácia API
- Dokumentácia API pre recepty
BasicNewsRecipeBasicNewsRecipe.adeify_images()BasicNewsRecipe.image_url_processor()BasicNewsRecipe.print_version()BasicNewsRecipe.tag_to_string()BasicNewsRecipe.abort_article()BasicNewsRecipe.abort_recipe_processing()BasicNewsRecipe.add_toc_thumbnail()BasicNewsRecipe.canonicalize_internal_url()BasicNewsRecipe.cleanup()BasicNewsRecipe.clone_browser()BasicNewsRecipe.default_cover()BasicNewsRecipe.download()BasicNewsRecipe.extract_readable_article()BasicNewsRecipe.get_article_url()BasicNewsRecipe.get_browser()BasicNewsRecipe.get_cover_url()BasicNewsRecipe.get_extra_css()BasicNewsRecipe.get_feeds()BasicNewsRecipe.get_masthead_title()BasicNewsRecipe.get_masthead_url()BasicNewsRecipe.get_obfuscated_article()BasicNewsRecipe.get_url_specific_delay()BasicNewsRecipe.index_to_soup()BasicNewsRecipe.is_link_wanted()BasicNewsRecipe.parse_feeds()BasicNewsRecipe.parse_index()BasicNewsRecipe.populate_article_metadata()BasicNewsRecipe.postprocess_book()BasicNewsRecipe.postprocess_html()BasicNewsRecipe.preprocess_html()BasicNewsRecipe.preprocess_image()BasicNewsRecipe.preprocess_raw_html()BasicNewsRecipe.publication_date()BasicNewsRecipe.skip_ad_pages()BasicNewsRecipe.sort_index_by()BasicNewsRecipe.warmup_excluded_domains()BasicNewsRecipe.articles_are_obfuscatedBasicNewsRecipe.auto_cleanupBasicNewsRecipe.auto_cleanup_keepBasicNewsRecipe.browser_typeBasicNewsRecipe.center_navbarBasicNewsRecipe.compress_news_imagesBasicNewsRecipe.compress_news_images_auto_sizeBasicNewsRecipe.compress_news_images_max_sizeBasicNewsRecipe.conversion_optionsBasicNewsRecipe.cover_marginsBasicNewsRecipe.delayBasicNewsRecipe.descriptionBasicNewsRecipe.encodingBasicNewsRecipe.extra_cssBasicNewsRecipe.feedsBasicNewsRecipe.filter_regexpsBasicNewsRecipe.handle_gzipBasicNewsRecipe.ignore_duplicate_articlesBasicNewsRecipe.keep_only_tagsBasicNewsRecipe.languageBasicNewsRecipe.masthead_urlBasicNewsRecipe.match_regexpsBasicNewsRecipe.max_articles_per_feedBasicNewsRecipe.needs_subscriptionBasicNewsRecipe.no_stylesheetsBasicNewsRecipe.oldest_articleBasicNewsRecipe.preprocess_regexpsBasicNewsRecipe.publication_typeBasicNewsRecipe.recipe_disabledBasicNewsRecipe.recipe_specific_optionsBasicNewsRecipe.recursionsBasicNewsRecipe.remove_attributesBasicNewsRecipe.remove_empty_feedsBasicNewsRecipe.remove_javascriptBasicNewsRecipe.remove_tagsBasicNewsRecipe.remove_tags_afterBasicNewsRecipe.remove_tags_beforeBasicNewsRecipe.requires_versionBasicNewsRecipe.resolve_internal_linksBasicNewsRecipe.reverse_article_orderBasicNewsRecipe.scale_news_imagesBasicNewsRecipe.scale_news_images_to_deviceBasicNewsRecipe.simultaneous_downloadsBasicNewsRecipe.summary_lengthBasicNewsRecipe.template_cssBasicNewsRecipe.timefmtBasicNewsRecipe.timeoutBasicNewsRecipe.titleBasicNewsRecipe.use_embedded_content