 Ändra språk
Lägga till din favoritnyhetswebbplats
calibre har ett kraftfullt, flexibelt och lättanvänt ramverk för att hämta nyheter från Internet och konvertera dem till en e-bok. Följande kommer att visa dig, med hjälp av exempel, hur du får nyheter från olika webbplatser.
För att få en förståelse för hur man använder ramverket, följ exemplen i den ordning som anges nedan:
Helt automatisk hämtning
Om nyhetskällan är tillräckligt enkel kan calibre kanske hämta den helt automatiskt. Du behöver bara ange URL:en. calibre samlar all information som behövs för att hämta en nyhetskälla i ett recept. För att informera calibre om en nyhetskälla måste du skapa ett recept för den. Här följer några exempel:
calibre-bloggen
calibre-bloggen innehåller inlägg som beskriver många användbara calibre-funktioner på ett enkelt och lättillgängligt sätt för nya användare. För att hämta bloggen som en e-bok använder vi bloggens RSS-flöde:
http://blog.calibre-ebook.com/feeds/posts/default
Jag fick RSS-URL:en genom att titta under ”Prenumerera” längst ner på bloggsidan och välja Posts → Atom. För att låta calibre hämta flödena och konvertera dem till en e-bok, bör du högerklicka på knappen Hämta nyheter och sedan på menyalternativet Lägg till en anpassad nyhetskälla och sedan knappen Nytt recept. En dialogruta liknande den som visas nedan bör öppnas.
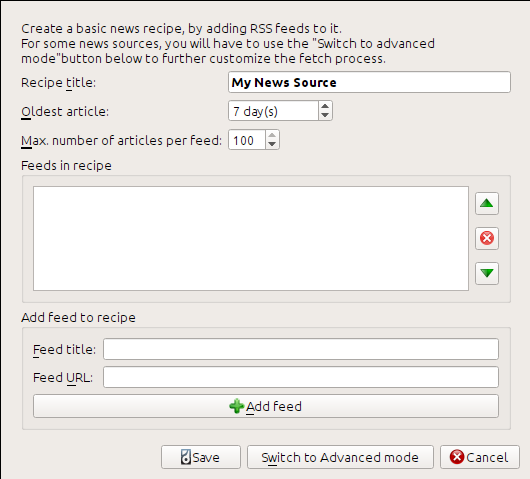
Ange först Calibre Blog i fältet Recepttitel. Detta kommer att vara titeln på e-boken som kommer att skapas från artiklarna i ovanstående flöden.
Med de två följande fälten (Äldsta artikel och Högst antal artiklar) kan du i viss mån styra hur många artiklar som ska hämtas från varje flöde. Fälten är i stort sett självförklarande.
För att lägga till flöden till receptet, mata in flödestitel och flödes-URL:en och klicka på knappen Lägg till flöde. När du har lagt till flödet klickar du på knappen Spara och du är klar! Stäng dialogrutan.
För att testa ditt nya recept klickar du på knappen Hämta nyheter och sedan på calibre Blog i undermenyn Anpassade nyhetskällor. Efter ett par minuter visas den nyligen hämtade e-boken med blogginlägg i biblioteksvyn. Om läsenheten är ansluten läggs den i stället till på läsenheten. Markera den och klicka på knappen Visa för att läsa den.
Det fungerade så bra med så liten arbetsinsats eftersom bloggen tillhandahåller RSS-flöden med fullständigt innehåll, det vill säga artikeltexten är inbäddad i själva flödet. För de flesta nyhetskällor som tillhandahåller sådana flöden behövs inget ytterligare arbete för att konvertera dem till e-böcker. Nu ska vi titta på en nyhetskälla som inte tillhandahåller flöden med fullständigt innehåll. I sådana flöden finns hela artikeln på en webbsida, medan flödet bara innehåller en länk till sidan och en kort sammanfattning av artikeln.
bbc.co.uk
Låt oss testa följande två flöden från BBC:
Följ proceduren i calibre-bloggen ovan för att skapa ett recept för BBC med flödena ovan. I den hämtade e-boken ser vi att calibre har lyckats ganska bra med att hämta ut enbart det relevanta innehållet från varje artikels webbsida. Processen är dock inte perfekt. Ibland lämnas oönskat innehåll kvar, till exempel menyer och navigeringshjälpmedel, eller så tas innehåll bort som borde ha behållits, till exempel artikelrubriker. För att få med exakt rätt innehåll behöver vi anpassa hämtningsprocessen enligt nästa avsnitt.
Anpassa hämtningsprocessen
När du vill finslipa hämtningsprocessen eller hämta innehåll från en särskilt komplex webbplats kan du använda alla möjligheter i ramverket för recept. Klicka då på knappen Växla till avancerat läge i dialogrutan Lägg till anpassade nyhetskällor.
Den enklaste och ofta mest effektiva anpassningen är att använda artiklarnas utskriftsversioner. De innehåller vanligtvis mycket mindre ovidkommande material och är lättare att konvertera till en e-bok. Låt oss försöka använda utskriftsversionerna av artiklarna från BBC.
Använda utskriftsversionen av bbc.co.uk
Det första steget är att titta på e-boken som vi tidigare hämtade från bbc.co.uk. I slutet av varje artikel finns en kort text som anger varifrån artikeln hämtades. Kopiera URL:en och klistra in den i en webbläsare. Leta sedan efter en länk till ”Utskriftsversion” på artikelns webbsida. Klicka på den för att visa artikelns utskriftsversion. Den ser mycket prydligare ut! Jämför nu de två URL:erna. För mig var de:
För att hämta utskriftsversionen verkar vi alltså behöva lägga följande prefix framför varje artikeladress:
newsvote.bbc.co.uk/mpapps/pagetools/print/
Nu i Avancerat läge i dialogrutan Anpassade nyhetskällor ska du se något liknande (kom ihåg att välja BBC-receptet innan du växlar till avancerat läge):
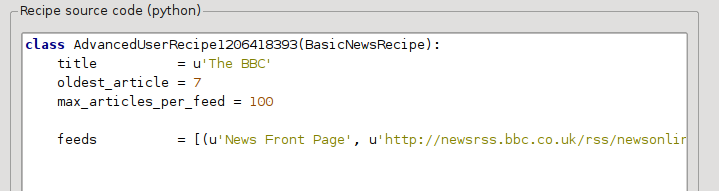
Du kan se att fälten från Grundläge har översatts till Python-kod på ett enkelt sätt. Vi måste lägga till instruktioner som får receptet att använda artiklarnas utskriftsversioner. Det enda som behövs är följande två rader:
def print_version(self, url):
    return url.replace('https://', 'https://newsvote.bbc.co.uk/mpapps/pagetools/print/')
Detta är Python, så indrag är viktigt. När du har lagt till raderna ska det se ut som:
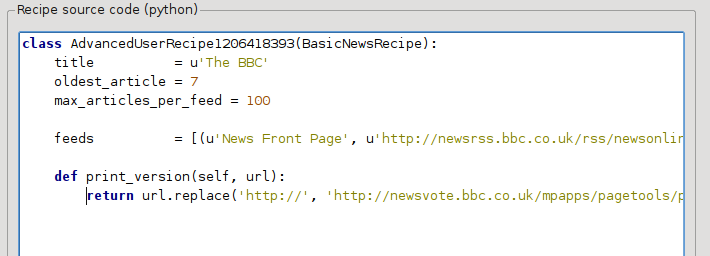
I exemplet ovan definierar def print_version(self, url) en metod som calibre anropar för varje artikel. url är den ursprungliga artikelns URL. Metoden print_version tar denna URL och ersätter den med den nya URL som leder till artikelns utskriftsversion. Mer information om Python finns i handledningen.
Nu klickar du på knappen Lägg till/uppdatera recept och dina ändringar sparas. Hämta e-boken igen. Du borde nu ha en mycket förbättrad e-bok. Ett av problemen med den nya versionen är att teckensnitten på utskriftsversionens webbplats är för små. Det här är automatiskt åtgärdat vid konvertering till en e-bok, men även efter justeringsprocessen blir teckensnittsstorleken på menyer och navigeringsfältet för stor i förhållande till artikeltexten. För att åtgärda det här, kommer vi att göra lite mer anpassning, i nästa avsnitt.
Ersätta artiklarnas formatmallar
I föregående avsnitt såg vi att teckenstorleken i artiklar från utskriftsversionen av BBC var för liten. På de flesta webbplatser, inklusive BBC, anges teckenstorleken med hjälp av CSS-formatmallar. Vi kan förhindra att sådana formatmallar hämtas genom att lägga till raden:
no_stylesheets = True
Receptet ser nu ut så här:
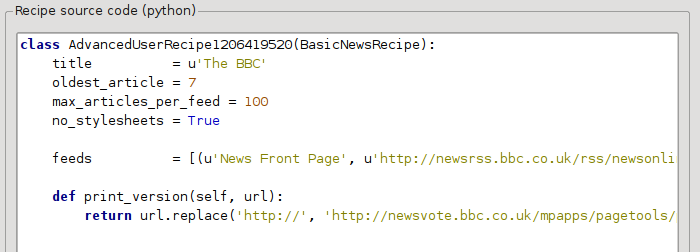
Den nya versionen ser ganska bra ut. Om du är perfektionist vill du nog läsa nästa avsnitt, som handlar om att ändra själva det hämtade innehållet.
Bearbeta innehållet
calibre har kraftfulla och flexibla funktioner för att bearbeta hämtat innehåll. För att visa ett par av dem tittar vi återigen på receptet BBC. I källkoden (HTML) för ett par artiklars utskriftsversioner ser vi en sidfot utan användbar information, innesluten i
<div class="footer">
...
</div>
Detta kan tas bort genom att lägga till:
remove_tags = [dict(name='div', attrs={'class':'footer'})]
till receptet. Låt oss slutligen ersätta en del av CSS som vi inaktiverade tidigare med vår egen CSS som är lämplig för konvertering till en e-bok:
extra_css = '.headline {font-size: x-large;} \n .fact { padding-top: 10pt }'
Med dessa tillägg är vårt recept redo för praktisk användning.
Detta recept visar bara en liten del av vad calibre kan göra. För att utforska fler av möjligheterna tittar vi på ett mer komplext exempel från verkligheten i nästa avsnitt.
Exempel i verkligheten
Ett relativt komplext exempel från verkligheten som visar mer av API:et för BasicNewsRecipe är receptet för The New York Times
import string, re
from calibre import strftime
from calibre.web.feeds.recipes import BasicNewsRecipe
from calibre.ebooks.BeautifulSoup import BeautifulSoup

class NYTimes(BasicNewsRecipe):

    title       = 'The New York Times'
    __author__  = 'Kovid Goyal'
    description = 'Daily news from the New York Times'
    timefmt = ' [%a, %d %b, %Y]'
    needs_subscription = True
    remove_tags_before = dict(id='article')
    remove_tags_after  = dict(id='article')
    remove_tags = [dict(attrs={'class':['articleTools', 'post-tools', 'side_tool', 'nextArticleLink clearfix']}),
                dict(id=['footer', 'toolsRight', 'articleInline', 'navigation', 'archive', 'side_search', 'blog_sidebar', 'side_tool', 'side_index']),
                dict(name=['script', 'noscript', 'style'])]
    encoding = 'cp1252'
    no_stylesheets = True
    extra_css = 'h1 {font: sans-serif large;}\n.byline {font:monospace;}'

    def get_browser(self):
        br = BasicNewsRecipe.get_browser(self)
        if self.username is not None and self.password is not None:
            br.open('https://www.nytimes.com/auth/login')
            br.select_form(name='login')
            br['USERID']   = self.username
            br['PASSWORD'] = self.password
            br.submit()
        return br

    def parse_index(self):
        soup = self.index_to_soup('https://www.nytimes.com/pages/todayspaper/index.html')

        def feed_title(div):
            return ''.join(div.findAll(text=True, recursive=False)).strip()

        articles = {}
        key = None
        ans = []
        for div in soup.findAll(True,
             attrs={'class':['section-headline', 'story', 'story headline']}):

             if ''.join(div['class']) == 'section-headline':
                 key = string.capwords(feed_title(div))
                 articles[key] = []
                 ans.append(key)

             elif ''.join(div['class']) in ['story', 'story headline']:
                 a = div.find('a', href=True)
                 if not a:
                     continue
                 url = re.sub(r'\?.*', '', a['href'])
                 url += '?pagewanted=all'
                 title = self.tag_to_string(a, use_alt=True).strip()
                 description = ''
                 pubdate = strftime('%a, %d %b')
                 summary = div.find(True, attrs={'class':'summary'})
                 if summary:
                     description = self.tag_to_string(summary, use_alt=False)

                 feed = key if key is not None else 'Uncategorized'
                 if feed not in articles:
                     articles[feed] = []
                 if not 'podcasts' in url:
                     articles[feed].append(
                               dict(title=title, url=url, date=pubdate,
                                    description=description,
                                    content=''))
        ans = self.sort_index_by(ans, {'The Front Page':-1, 'Dining In, Dining Out':1, 'Obituaries':2})
        ans = [(key, articles[key]) for key in ans if key in articles]
        return ans

    def preprocess_html(self, soup):
        refresh = soup.find('meta', {'http-equiv':'refresh'})
        if refresh is None:
            return soup
        content = refresh.get('content').partition('=')[2]
        raw = self.browser.open('https://www.nytimes.com'+content).read()
        return BeautifulSoup(raw.decode('cp1252', 'replace'))
Vi ser flera nya funktioner i detta recept. Först har vi:
timefmt = ' [%a, %d %b, %Y]'
Detta anger att tiden på den skapade e-bokens förstasida ska visas i formatet Dag, dagnummer månad, år. Se timefmt.
Då ser vi en grupp direktiv för att rensa hämtad HTML:
remove_tags_before = dict(name='h1')
remove_tags_after  = dict(id='footer')
remove_tags = ...
Dessa tar bort allt innan den första <h1>-taggen och allt efter den första taggen vars id är footer. Se remove_tags, remove_tags_before, remove_tags_after.
Nästa intressanta funktion är:
needs_subscription = True
...
def get_browser(self):
    ...
needs_subscription = True berättar för calibre att detta recept behöver användarnamn och lösenord för att komma åt innehållet. Detta medför att calibre frågar efter användarnamn och lösenord när du försöker använda det här receptet. Koden i calibre.web.feeds.news.BasicNewsRecipe.get_browser() loggar faktiskt in på NYT-webbplatsen. När du loggat in kommer calibre att använda samma webbläsarinstans för att hämta allt innehåll. Se mechanize för att förstå koden i get_browser.
Nästa nya funktion är metoden calibre.web.feeds.news.BasicNewsRecipe.parse_index(). Den går till https://www.nytimes.com/pages/todayspaper/index.html och hämtar listan över artiklar i dagens tidning. Detta är mer komplicerat än att bara använda RSS, men receptet skapar en e-bok som mycket nära motsvarar dagens tidning. parse_index använder BeautifulSoup i stor utsträckning för att tolka webbsidan med dagens tidning. Du kan också använda andra, modernare tolkar om du inte vill använda BeautifulSoup. calibre levereras med lxml och html5lib, som är de rekommenderade tolkarna. Ersätt anropet till index_to_soup() med följande för att använda dem:
raw = self.index_to_soup(url, raw=True)
# For html5lib
import html5lib
root = html5lib.parse(raw, namespaceHTMLElements=False, treebuilder='lxml')
# For the lxml html 4 parser
from lxml import html
root = html.fromstring(raw)
Den sista nya funktionen är metoden calibre.web.feeds.news.BasicNewsRecipe.preprocess_html(). Den kan användas för att utföra godtyckliga omvandlingar på varje hämtad HTML-sida. Här används den för att kringgå annonserna som nytimes visar före varje artikel.
Tips för att utveckla nya recept
Det bästa sättet att utveckla nya recept är att använda kommandoradsgränssnittet. Skapa receptet i den Python-redigerare du föredrar och spara det i en fil, till exempel myrecipe.recipe. Filändelsen .recipe krävs. Du kan hämta innehåll med receptet med följande kommando:
ebook-convert myrecipe.recipe .epub --test -vv --debug-pipeline debug
Kommandot ebook-convert hämtar alla webbsidor och sparar dem i EPUB-filen myrecipe.epub. Flaggan -vv gör att ebook-convert skriver ut utförlig information om vad programmet gör. Flaggan ebook-convert-recipe-input --test begränsar hämtningen till ett par artiklar från högst två flöden. Dessutom placerar ebook-convert den hämtade HTML-koden i mappen debug/input, där debug är den mapp du angav med flaggan ebook-convert --debug-pipeline.
När hämtningen är klar kan du titta på hämtad HTML genom att öppna filen debug/input/index.html i en webbläsare. När du är nöjd med att hämtningen och förbehandling sker korrekt kan du skapa e-böcker i olika format enligt nedan:
ebook-convert myrecipe.recipe myrecipe.epub
ebook-convert myrecipe.recipe myrecipe.mobi
...
Om du är nöjd med ditt recept och du känner att det finns tillräcklig efterfrågan för att motivera dess införande i uppsättningen av inbyggda recept, lägg upp ditt recept i calibres receptforum för att dela med andra calibre-användare.
Anteckning
I macOS finns kommandoradsverktygen inuti calibre-paketet. Om du till exempel installerade calibre i /Applications finns verktygen i /Applications/calibre.app/Contents/MacOS/.
Se även
- ebook-convert
Kommandoradsgränssnittet för all e-bokkonvertering.
Ytterligare läsning
Om du vill veta mer om att skriva avancerade recept med funktionerna i BasicNewsRecipe kan du läsa följande källor:
- API-dokumentation
Dokumentation av
BasicNewsRecipe-klassen och alla dess viktiga metoder och fält.- BasicNewsRecipe
Källkoden för
BasicNewsRecipe- Inbyggda recept
Källkoden för de inbyggda recept som kommer med calibre
- calibre-receptforumet
Här finns massor av kunniga receptförfattare för calibre.
API-dokumentation
- API-dokumentation för recept
BasicNewsRecipeBasicNewsRecipe.adeify_images()BasicNewsRecipe.image_url_processor()BasicNewsRecipe.print_version()BasicNewsRecipe.tag_to_string()BasicNewsRecipe.abort_article()BasicNewsRecipe.abort_recipe_processing()BasicNewsRecipe.add_toc_thumbnail()BasicNewsRecipe.canonicalize_internal_url()BasicNewsRecipe.cleanup()BasicNewsRecipe.clone_browser()BasicNewsRecipe.default_cover()BasicNewsRecipe.download()BasicNewsRecipe.extract_readable_article()BasicNewsRecipe.get_article_url()BasicNewsRecipe.get_browser()BasicNewsRecipe.get_cover_url()BasicNewsRecipe.get_extra_css()BasicNewsRecipe.get_feeds()BasicNewsRecipe.get_masthead_title()BasicNewsRecipe.get_masthead_url()BasicNewsRecipe.get_obfuscated_article()BasicNewsRecipe.get_url_specific_delay()BasicNewsRecipe.index_to_soup()BasicNewsRecipe.is_link_wanted()BasicNewsRecipe.parse_feeds()BasicNewsRecipe.parse_index()BasicNewsRecipe.populate_article_metadata()BasicNewsRecipe.postprocess_book()BasicNewsRecipe.postprocess_html()BasicNewsRecipe.preprocess_html()BasicNewsRecipe.preprocess_image()BasicNewsRecipe.preprocess_raw_html()BasicNewsRecipe.publication_date()BasicNewsRecipe.skip_ad_pages()BasicNewsRecipe.sort_index_by()BasicNewsRecipe.articles_are_obfuscatedBasicNewsRecipe.auto_cleanupBasicNewsRecipe.auto_cleanup_keepBasicNewsRecipe.browser_typeBasicNewsRecipe.center_navbarBasicNewsRecipe.compress_news_imagesBasicNewsRecipe.compress_news_images_auto_sizeBasicNewsRecipe.compress_news_images_max_sizeBasicNewsRecipe.conversion_optionsBasicNewsRecipe.cover_marginsBasicNewsRecipe.delayBasicNewsRecipe.descriptionBasicNewsRecipe.encodingBasicNewsRecipe.extra_cssBasicNewsRecipe.feedsBasicNewsRecipe.filter_regexpsBasicNewsRecipe.handle_gzipBasicNewsRecipe.ignore_duplicate_articlesBasicNewsRecipe.keep_only_tagsBasicNewsRecipe.languageBasicNewsRecipe.masthead_urlBasicNewsRecipe.match_regexpsBasicNewsRecipe.max_articles_per_feedBasicNewsRecipe.needs_subscriptionBasicNewsRecipe.no_stylesheetsBasicNewsRecipe.oldest_articleBasicNewsRecipe.preprocess_regexpsBasicNewsRecipe.publication_typeBasicNewsRecipe.recipe_disabledBasicNewsRecipe.recipe_specific_optionsBasicNewsRecipe.recursionsBasicNewsRecipe.remove_attributesBasicNewsRecipe.remove_empty_feedsBasicNewsRecipe.remove_javascriptBasicNewsRecipe.remove_tagsBasicNewsRecipe.remove_tags_afterBasicNewsRecipe.remove_tags_beforeBasicNewsRecipe.requires_versionBasicNewsRecipe.resolve_internal_linksBasicNewsRecipe.reverse_article_orderBasicNewsRecipe.scale_news_imagesBasicNewsRecipe.scale_news_images_to_deviceBasicNewsRecipe.simultaneous_downloadsBasicNewsRecipe.summary_lengthBasicNewsRecipe.template_cssBasicNewsRecipe.timefmtBasicNewsRecipe.timeoutBasicNewsRecipe.titleBasicNewsRecipe.use_embedded_content