 Ändra språk
Konvertering av e-böcker
calibres konverteringssystem är utformat för att vara lätt att använda. Vanligtvis lägger du bara till en bok i calibre och klickar på konvertera. calibre försöker då skapa ett resultat som ligger så nära originalet som möjligt. calibre stöder dock många inmatningsformat, och alla lämpar sig inte lika bra för konvertering till e-böcker. För sådana format, eller när du vill ha större kontroll, finns många alternativ för att finjustera konverteringen. Konverteringssystemet ersätter däremot inte en fullständig e-boksredigerare. För att redigera e-böcker rekommenderar jag att du först konverterar dem till EPUB eller AZW3 med calibre och sedan använder Redigera bok för att finjustera resultatet. Därefter kan du använda den redigerade e-boken som indata vid konvertering till andra format i calibre.
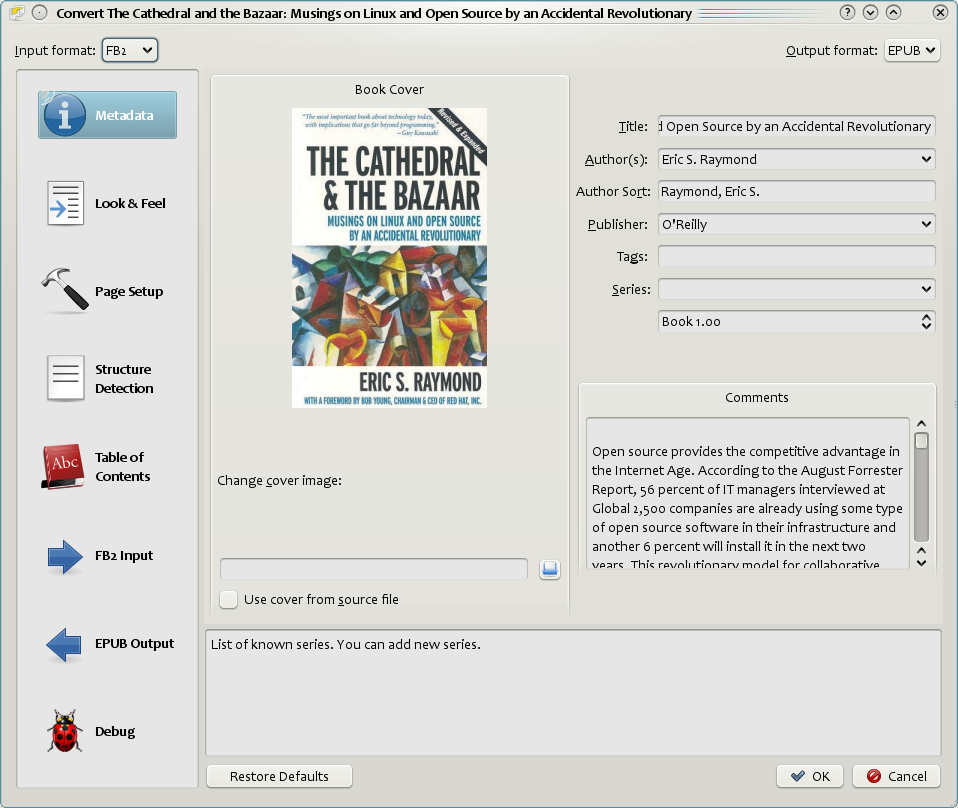
Det här dokumentet beskriver främst inställningarna i konverteringsdialogrutan som visas nedan. Alla inställningar finns även i kommandoradsgränssnittet för konvertering, som beskrivs i ebook-convert. Du får hjälp med en inställning i calibre genom att hålla muspekaren över den. Då visas ett verktygstips som beskriver inställningen.
Introduktion
Konverteringssystemet är uppbyggt som en kedja av bearbetningssteg. Schematiskt ser det ut så här:
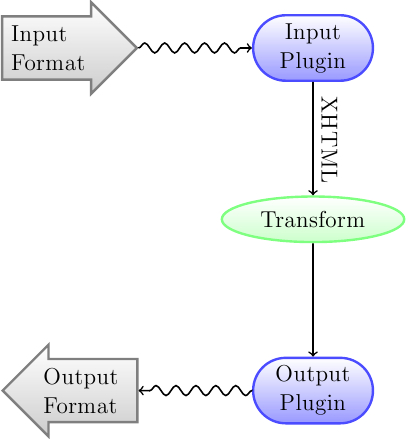
Inmatningsformatet konverteras först till XHTML av en lämplig inmatningsinsticksmodul. Därefter omvandlas denna HTML. I det sista steget konverteras den bearbetade XHTML-koden till det angivna utmatningsformatet av en lämplig utmatningsinsticksmodul. Resultatet kan variera kraftigt beroende på inmatningsformatet. Vissa format konverteras mycket bättre än andra. En lista över de bästa källformaten för konvertering finns här.
Omvandlingarna som verkar på XHTML-utmatningen är där allt arbete sker. Det finns olika omvandlingar, till exempel för att infoga bokens metadata som en sida i början av boken, för att upptäcka kapitelrubriker och automatiskt skapa en innehållsförteckning, för att proportionellt justera teckensnittsstorlekar, och så vidare. Det är viktigt att minnas att alla omvandlingar verkar på XHTML-utmatning av inmatningsinsticksmodulen, inte på själva inmatningsfilen. Så, till exempel, om du ber calibre att konvertera en RTF-fil till EPUB, kommer den först att konverteras till XHTML internt, de olika omvandlingarna kommer att tillämpas på XHTML och sedan kommer utmatningsinsticksmodulen att skapa EPUB-filen, vilket automatiskt skapar alla metadata, innehållsförteckning, och så vidare.
Du kan se den här processen i aktion genom att använda felsökningsalternativet  . Ange bara sökvägen till en mapp för felsökningsutmatning. Under konverteringen kommer calibre att placera XHTML som genereras av de olika stegen i konverteringsprocessen i olika undermappar. De fyra undermapparna är:
Mapp |
Beskrivning |
|---|---|
input |
Den innehåller HTML-utmatning från inmatningsinsticksmodulen. Använd detta för att felsöka inmatningsinsticksmodulen. |
parsed |
Resultatet efter att utmatningen från inmatningsinsticksmodulen har förbehandlats och konverterats till XHTML. Används för att felsöka strukturdetektering. |
structure |
Efter strukturdetektering, men före utplattning av CSS och konvertering av teckenstorlekar. Används för att felsöka konvertering av teckenstorlekar och CSS-omvandlingar. |
processed |
Precis innan e-boken skickas till utmatningsinsticksmodulen. Används för att felsöka utmatningsinsticksmodulen. |
Om du vill redigera inmatningsdokumentet lite innan calibre konverterar det är det bäst att redigera filerna i undermappen input och sedan packa dem i en ZIP-fil. Använd ZIP-filen som inmatningsformat vid efterföljande konverteringar. Lägg till ZIP-filen som ett format för boken via dialogrutan Redigera metainformation och välj sedan ZIP som inmatningsformat längst upp till vänster i konverteringsdialogrutan.
Det här dokumentet kommer huvudsakligen att behandla de olika omvandlingarna som fungerar på mellanliggande XHTML och hur man anpassar dem. I slutet finns några tips som är specifika för varje in-/utmatningsformat.
Utseende & känsla
Denna grupp av alternativ anpassar olika aspekter av utseendet och känslan av den konverterade e-boken.
Teckensnitt
En av de trevligaste funktionerna med e-läsningsupplevelsen är möjligheten att enkelt justera teckenstorlekar för att passa individuella behov och ljusförhållanden. calibre har sofistikerade algoritmer för att säkerställa att alla böcker som matas ut har konsekventa teckenstorlekar, oavsett vilka teckenstorlekar som anges i inmatningsdokumentet.
Grundteckensnittsstorleken för ett dokument är den vanligaste teckensnittsstorleken i det dokumentet, dvs. storleken på den största delen av texten i dokumentet. När du anger en Grundteckenstorlek, skalar calibre automatiskt om alla teckensnittsstorlekar i dokumentet proportionellt, så att den vanligaste teckensnittsstorleken blir den angivna grundteckensnittsstorleken och andra teckensnittsstorlekar skalas på lämpligt sätt. Genom att välja en större grundteckensnittsstorlek kan du göra teckensnitten i dokumentet större och vice versa. När du ställer in grundteckensnittsstorleken, för bästa resultat, bör du också ställa in teckensnittsstorleksnyckeln.
Normalt väljer calibre automatiskt en grundteckensnittsstorlek som är lämplig för utmatningsprofilen du har valt (se Sidinställning). Du kan dock åsidosätta detta här om standardvärdet inte är lämpligt för dig.
Alternativet Teckenstorleksnyckel styr hur andra teckenstorlekar än grundstorleken skalas om. Omskalningsalgoritmen använder en teckenstorleksnyckel, alltså en kommaseparerad lista med teckenstorlekar. Nyckeln anger hur många ”steg” större eller mindre en viss storlek ska vara jämfört med grundstorleken. Tanken är att ett dokument ska ha ett begränsat antal teckenstorlekar: en för brödtext, några för olika rubriknivåer och några för upphöjda eller nedsänkta tecken och fotnoter. Nyckeln låter calibre dela in inmatningsdokumentets teckenstorlekar i separata grupper som motsvarar de olika logiska storlekarna.
Låt oss illustrera med ett exempel. Antag att källdokumentet vi konverterar producerades av någon med utmärkt syn och har en grundteckensnittsstorlek på 8 punkter. Det innebär att huvuddelen av texten i dokumentet är dimensionerad för 8 punkter medan rubriker är något större (säg 10 och 12 punkter) och fotnoter något mindre på 6 punkter. Nu om vi använder följande inställningar:
Base font size : 12pt
Font size key  : 7, 8, 10, 12, 14, 16, 18, 20
Utmatningsdokumentet kommer att ha en grundteckensnittsstorlek på 12 punkter, rubrikerna 14 och 16 punkter och fotnoter 8 punkter. Anta nu att vi vill göra att den största rubrikstorleken sticker ut mer och göra fotnoter lite större också. För att uppnå detta bör teckensnittsnyckeln ändras till:
New font size key : 7, 9, 12, 14, 18, 20, 22
De största rubrikerna blir nu 18 punkter och fotnoterna 9 punkter. Prova olika inställningar för att hitta det som passar dig bäst. Guiden för omskalning av teckenstorlekar öppnas med den lilla knappen bredvid Teckenstorleksnyckel.
Alla omskalningar av teckensnittsstorleken i konverteringen kan även stängas av här, om du vill bevara teckensnittsstorlekar i inmatningsdokumentet.
En relaterad inställning är Radhöjd, som styr radernas vertikala höjd. Med standardvärdet 0 ändras inte radhöjderna. Om du anger ett annat värde används det på alla ställen där ingen egen radhöjd har angetts. Inställningen är dock ett trubbigt verktyg och bör användas sparsamt. Om du vill ändra radhöjden i vissa avsnitt är det bättre att använda Extra CSS.
Här kan du också låta calibre bädda in alla teckensnitt som boken hänvisar till. Då fungerar teckensnitten på läsenheter även om de inte är installerade där.
Text
Text kan vara marginaljusterad eller inte. Marginaljusterad text har extra mellanrum mellan orden för att skapa en jämn högermarginal. Vissa föredrar marginaljusterad text, medan andra inte gör det. Normalt bevarar calibre marginaljusteringen i originaldokumentet. Om du vill åsidosätta den kan du använda alternativet Textjustering i det här avsnittet.
Med Förbättra skiljeteckenhantering kan calibre ersätta raka citattecken, streck och tre punkter med typografiskt korrekta motsvarigheter. Algoritmen är inte perfekt, så granska resultatet. Den omvända funktionen, Återställ enkla skiljetecken, finns också.
Slutligen finns det Inmatningsteckenkodning. Äldre dokument anger ibland inte deras teckenkodning. Vid konvertering kan detta leda till att icke-engelska tecken eller specialtecken som typografiska citattecken skadas. calibre försöker att automatiskt upptäcka källdokumentets teckenkodning, men det lyckas inte alltid. Du kan tvinga den att anta en viss teckenkodning med den här inställningen. cp1252 är en vanlig kodning för dokument som produceras med Windows-programvara. Du bör också läsa Hur konverterar jag min fil som innehåller icke-engelska tecken eller typografiska citattecken? för mer om kodningsfrågor.
Layout
Normalt återges stycken i XHTML med en tom rad mellan sig och utan inledande textindrag. calibre har ett par alternativ för att styra detta. Ta bort avstånd mellan stycken tar bort allt avstånd mellan styckena. Alternativet ställer också in textindraget på 1.5em, vilket kan ändras, för att markera början på varje stycke. Infoga tom rad mellan stycken gör motsatsen och ser till att det finns exakt en tom rad mellan varje par av stycken. Båda alternativen gäller för alla stycken, tekniskt sett <p>- och <div>-taggar. På så sätt fungerar alternativet som utlovat oavsett hur rörig inmatningsfilen är. Undantaget är när inmatningsfilen använder hårda radbrytningar för att skapa avstånd mellan stycken.
Om du vill ta bort avstånd mellan alla stycken, förutom några få utvalda, använd inte dessa alternativ. Lägg i stället till följande CSS-kod i Extra CSS:
p, div { margin: 0pt; border: 0pt; text-indent: 1.5em }
.spacious { margin-bottom: 1em; text-indent: 0pt; }
Markera sedan styckena i ditt källdokument som behöver avstånd med class=”spacious”. Om ditt inmatningsdokument inte är i HTML, använd alternativet Felsökning, som beskrivs i inledningen för att hämta HTML (använd undermappen input).
Ett annat användbart alternativ är Konvertera data i tabeller till linjära data. Vissa dåligt utformade dokument använder tabeller för att styra textens placering på sidan. Vid konvertering kan texten då hamna utanför sidan och andra visningsfel uppstå. Alternativet plockar ut innehållet ur tabellerna och visar det i följd. Det påverkar alla tabeller, så använd det bara om du är säker på att dokumentet inte använder tabeller till exempel för att presentera tabellinformation.
Formgivning
Med Extra CSS kan du ange valfri CSS som tillämpas på alla HTML-filer i inmatningen. Den tillämpas med mycket hög prioritet och bör därför åsidosätta det mesta av den CSS som finns i själva inmatningsdokumentet. Inställningen kan finjustera dokumentets utseende och layout. Om du till exempel vill högerjustera alla stycken med klassen endnote lägger du till:
.endnote { text-align: right }
eller om du vill ändra indraget för alla stycken:
p { text-indent: 5mm; }
Extra CSS är ett kraftfullt alternativ, men du behöver förstå hur CSS fungerar för att utnyttja det fullt ut. Med felsökningsalternativet för konverteringsprocessen som beskrivs ovan kan du se vilken CSS som finns i inmatningsdokumentet.
Ett enklare alternativ är att använda Filtrera formatinformation. Det här låter dig ta bort alla CSS-egenskaper för de angivna typerna från dokumentet. Du kan till exempel använda den för att ta bort alla färger eller teckensnitt.
Omvandla stilar
Det här är den mest kraftfulla funktionen för att ändra stilar. Du kan definiera regler som ändrar dem utifrån olika villkor, till exempel ändra alla gröna färger till blå, ta bort all fetstil eller ge alla rubriker en viss färg.
Omvandla HTML
Funktionen liknar omvandling av stilar men ändrar i stället bokens HTML-innehåll. Du kan ersätta en tagg med en annan, lägga till klasser eller andra attribut i taggar beroende på deras innehåll och så vidare.
Sidinställning
Alternativen under Sidinställning styr sidans layout, till exempel marginaler och skärmstorlek. Sidmarginalerna används av utmatningsinsticksmodulen om utmatningsformatet stöder dem. Du bör också välja en inmatningsprofil och en utmatningsprofil. Profilerna styr främst hur mått i in- och utmatningsdokumenten ska tolkas, skärmstorlekar och standardnycklar för omskalning av teckenstorlekar.
Om du vet att filen du konverterar var avsedd att användas på en viss enhet/mjukvaruplattform väljer du motsvarande inmatningsprofil, annars väljer du bara standardinmatningsprofilen. Om du vet att filerna du producerar är avsedda för en viss enhetstyp väljer du motsvarande utmatningsprofil. Annars väljer du en av de generiska utmatningsprofilerna. Om du konverterar till MOBI eller AZW3 vill du nästan alltid välja en av Kindle-utmatningsprofilerna. Annars är det bästa alternativet för moderna e-bokläsenheterna att välja utmatningsprofilen Generisk e-bläck HD.
Utmatningsprofilen styr också skärmstorleken. I vissa utmatningsformat anpassas till exempel bilder automatiskt till skärmen. Välj därför en profil för en enhet med ungefär samma skärmstorlek som din egen.
Heuristisk bearbetning
Heuristisk bearbetning innehåller funktioner som försöker identifiera och rätta vanliga problem i dåligt formaterade inmatningsdokument. Använd dem om dokumentet har sådana problem. Funktionerna bygger på vanliga mönster och kan ibland försämra resultatet, så använd dem med försiktighet. Flera alternativ kan till exempel ta bort alla entiteter för hårda blanksteg eller felaktigt identifiera text som ska bearbetas.
- Aktivera heuristisk bearbetning
Det här alternativet aktiverar steget Heuristisk bearbetning i calibres konverteringsprocess. Det måste vara aktiverat för att underfunktionerna ska kunna tillämpas.
- Ta bort radbrytningar
När alternativet är aktiverat försöker calibre identifiera och rätta hårda radbrytningar utifrån skiljetecken och radlängd. Först undersöks om hårda radbrytningar verkar finnas. Om inte försöker calibre inte ta bort några. Du kan minska faktorn för borttagning av radbrytningar för att ”tvinga” calibre att ta bort dem.
- Faktor för borttagning av radbrytningar
Det här alternativet styr algoritmen calibre använder för att ta bort hårda radbrytningar. Till exempel, om värdet av det här alternativet är 0,4, innebär det att calibre tar bort hårda radbrytningar från slutet av rader vars längd är mindre än längden på 40% av alla rader i dokumentet. Om ditt dokument bara har några radbrytningar som behöver korrigering, bör detta värde minskas till någonstans mellan 0,1 och 0,2.
- Identifiera och märk upp oformaterade kapitelrubriker och underrubriker
Om kapitelrubriker och titlar inte är formaterade annorlunda än resten av texten försöker calibre identifiera dem och omsluta dem med rubriktaggar. <h2>-taggar används för kapitelrubriker och <h3>-taggar för andra titlar som identifieras.
Den här funktionen skapar inte en innehållsförteckning, men i många fall kommer den att orsaka calibres standardinställningar för kapiteldetektering att korrekt detektera kapitel och bygga en innehållsförteckning. Justera XPath under Strukturdetektering om en innehållsförteckning inte skapas automatiskt. Om det inte finns några andra rubriker i dokumentet skulle det vara det enklaste sättet att skapa en innehållsförteckning för dokumentet att ställa in ”//h:h2” under strukturdetektering.
De infogade rubrikerna är inte formaterade. Använd Extra CSS under konverteringsinställningarna för Utseende och känsla för att formatera dem. Om du till exempel vill centrera rubrikerna använder du följande:
h2, h3 { text-align: center }
- Numrera om sekvenser av <h1>- eller <h2>-taggar för att förhindra uppdelning
Vissa utgivare formaterar kapitelrubriker med flera <h1>- eller <h2>-taggar i följd. calibres standardinställningar för konvertering kan då dela upp rubriken i två delar. Det här alternativet numrerar om rubriktaggarna för att förhindra uppdelningen.
- Ta bort tomma rader mellan stycken
Med det här alternativet analyserar calibre dokumentets tomma rader. Om varje stycke följs av en tom rad tas dessa tomma stycken bort. Flera tomma rader i följd tolkas som en scenbrytning och bevaras som ett enda stycke. Till skillnad från Ta bort avstånd mellan stycken under Utseende & känsla ändrar alternativet själva HTML-innehållet, medan det andra ändrar dokumentets stilar. Det kan även ta bort stycken som infogats med calibres alternativ Infoga tom rad mellan stycken.
- Se till att scenbrytningar är konsekvent formaterade
Med det här alternativet försöker calibre identifiera vanliga markörer för scenbrytningar och centrera dem. ”Mjuka” scenbrytningar, som enbart markeras med extra tomrum, formateras så att de inte visas i samband med sidbrytningar.
- Ersätt mjuka scenbrytningar
Om det här alternativet är anpassat kommer calibre att ersätta scenbrytningsmarkörer som den hittar med den ersättningstext som användaren angett. Observera att vissa prydnadstecken kanske inte stöds på alla läsenheter.
Undvik i allmänhet HTML-taggar, eftersom calibre tar bort dem och använder fördefinierad uppmärkning. Undantagen är <hr />-taggar för vågräta linjer och <img>-taggar. Vågräta linjer kan förses med stilar. Om du anger en egen stil måste den innehålla egenskapen ”width”, annars tas stilinformationen bort. Bildtaggar kan också användas, men calibre kan inte lägga till själva bilden under konverteringen. Det måste göras i efterhand med funktionen ”Redigera bok”.
- Exempel på en bildtagg (lägg bilden i en mapp med namnet ”Images” inuti EPUB-filen efter konverteringen):
<img style=”width:10%” src=”../Images/scenebreak.png” />
- Exempel på en vågrät linje med stilar:
<hr style=”width:20%;padding-top: 1px;border-top: 2px ridge black;border-bottom: 2px groove black;”/>
- Ta bort onödiga bindestreck
När alternativet är aktiverat analyserar calibre alla ord med bindestreck i dokumentet. Dokumentet självt används som ordbok för analysen. Därmed kan calibre ta bort bindestreck korrekt i ord på valfritt språk, även påhittade ord och ovanliga vetenskapliga termer. Nackdelen är att ord som bara förekommer en gång inte ändras. Analysen görs i två steg. Först analyseras radsluten. Radbrytningar tas endast bort om ordet finns med eller utan bindestreck i dokumentet. Därefter analyseras alla ord med bindestreck i hela dokumentet. Bindestrecken tas bort om ordet förekommer någon annanstans i dokumentet utan matchning.
- Kursivera vanliga ord och mönster
När det är aktiverat kommer calibre att leta efter vanliga ord och mönster som betecknar kursiv stil och kursiverar dem. Exempel är vanliga textkonventioner som ~word~ eller fraser som generellt bör kursiveras, t.ex. latinska fraser som ’etc.’ eller ’et cetera’.
- Ersätt entitetsindrag med CSS-indrag
Vissa dokument skapar textindrag med entiteter för hårda blanksteg. När alternativet är aktiverat försöker calibre identifiera sådan formatering och ersätta den med ett textindrag på 3 % i CSS.
Sök och ersätt
Dessa alternativ är främst användbara för konvertering av PDF-dokument eller OCR-konverteringar, men de kan också användas för att åtgärda många dokumentspecifika problem. Som ett exempel kan vissa konverteringar lämna kvar sidhuvuden och sidfötter i texten. Dessa alternativ använder reguljära uttryck för att försöka upptäcka sidhuvuden, sidfötter eller annan godtycklig text och ta bort eller ersätta dem. Kom ihåg att de fungerar på den mellanliggande XHTML som produceras av konverteringsprocessen. Det finns en guide som hjälper dig att anpassa de reguljära uttrycken för ditt dokument. Klicka på trollstaven bredvid uttrycksrutan och klicka på knappen ”Testa” efter att du har skrivit ditt sökuttryck. Framgångsrika träffar markeras med gult.
Sökningen använder ett reguljärt Python-uttryck. All matchad text tas bort från dokumentet eller ersätts med ersättningsmönstret. Ersättningsmönstret är valfritt. Om det lämnas tomt tas text som matchar sökmönstret bort från dokumentet. Du kan läsa mer om reguljära uttryck och deras syntax i Allt om att använda reguljära uttryck i calibre.
Strukturdetektering
Strukturdetektering innebär att calibre försöker identifiera strukturella element i inmatningsdokumentet som inte har angetts korrekt, till exempel kapitel, sidbrytningar, sidhuvuden och sidfötter. Processen varierar mycket mellan olika böcker. calibre har kraftfulla alternativ för att styra den. Alternativen kan vara komplicerade, men det lönar sig att lära sig hur de fungerar.
Kapitel och sidbrytningar
calibre har två uppsättningar alternativ för kapiteldetektering och infogning av sidbrytningar. Detta kan ibland vara lite förvirrande, eftersom calibre som standard infogar sidbrytningar före upptäckta kapitel såväl som de platser som upptäcks av alternativet för sidbrytningar. Anledningen till detta är att det ofta finns platser där sidbrytningar ska infogas som inte är kapitelgränser. Dessutom kan upptäckta kapitel valfritt infogas i den automatiskt genererade innehållsförteckningen.
calibre använder XPath, ett kraftfullt språk för att göra det möjligt för användaren att specificera kapitelgränser/sidbrytningar. XPath kan verka lite skrämmande att använda till en början, lyckligtvis finns det en XPath-handledning i användarmanualen. Kom ihåg att strukturdetektering fungerar på den mellanliggande XHTML som produceras av konverteringsprocessen. Använd felsökningsalternativet som beskrivs i Introduktion för att ta reda på lämpliga inställningar för din bok. Det finns också en knapp för en XPath-guide som hjälper till med skapande av enkla XPath-uttryck.
Som standard använder calibre följande uttryck för att identifiera kapitel:
//*[((name()='h1' or name()='h2') and re:test(., 'chapter|book|section|part\s+', 'i')) or @class = 'chapter']
Uttrycket är ganska komplicerat eftersom det hanterar flera vanliga fall samtidigt. Det innebär att calibre antar att kapitel börjar vid <h1>- eller <h2>-taggar som innehåller något av orden (chapter, book, section or part) eller har attributet class=”chapter”.
Med det relaterade alternativet Kapitelmarkering styr du vad calibre gör när ett kapitel identifieras. Som standard infogas en sidbrytning före kapitlet. Du kan i stället infoga en linje, eller både en linje och en sidbrytning. Du kan också välja att inte göra någonting.
Standardinställningen för att upptäcka sidbrytningar är:
//*[name()='h1' or name()='h2']
vilket innebär att calibre som standard infogar sidbrytningar före varje <h1>- och <h2>-tagg.
Anteckning
Standarduttryck kan ändras beroende på inmatningsformat du konverterar.
Diverse
Det finns några fler alternativ i det här avsnittet.
- Infoga metadata som en sida i början av boken
calibre låter dig hålla utförliga metadata om alla dina böcker, till exempel betyg, taggar och kommentarer. Det här alternativet samlar dessa metadata på en sida och infogar den i den konverterade e-boken, vanligtvis direkt efter omslaget. På så sätt skapar du en egen anpassad metadatasida.
- Ta bort första bilden
Ibland ingår omslaget i källdokumentets innehåll i stället för att vara ett separat omslag. Om du även anger ett omslag i calibre får den konverterade boken två omslag. Det här alternativet tar bort den första bilden ur källdokumentet så att den konverterade boken endast har omslaget som angetts i calibre.
Innehållsförteckning
Om inmatningsdokumentet har en innehållsförteckning i sina metadata använder calibre den. En del äldre format saknar dock stöd för detta, och även i format som stöder det kan innehållsförteckningen saknas. Då kan alternativen här automatiskt skapa en innehållsförteckning i den konverterade e-boken utifrån inmatningsdokumentets faktiska innehåll.
Anteckning
Det kan vara svårt att få exakt rätt resultat med de här alternativen. Om du hellre skapar eller redigerar innehållsförteckningen manuellt kan du konvertera till EPUB eller AZW3 och markera Finjustera innehållsförteckningen manuellt efter att konverteringen är klar längst ner under Innehållsförteckning i konverteringsdialogrutan. Då öppnas innehållsförteckningsredigeraren efter konverteringen. Där kan du skapa poster genom att klicka på den plats i boken som de ska hänvisa till. Redigeraren kan också användas separat. Gå till Inställningar → Gränssnitt → Verktygsfält och lägg till Redigera innehållsförteckning i huvudverktygsfältet. Markera sedan boken och klicka på Redigera innehållsförteckning.
Det första alternativet är Tvinga användning av automatiskt genererad innehållsförteckning. Genom att markera det här alternativet kan du få calibre att åsidosätta innehållsförteckningar som finns i metadata för inmatningsdokumentet med den automatiskt genererade.
Som standard försöker calibre först lägga till de identifierade kapitlen i den automatiskt genererade innehållsförteckningen. Hur du anpassar kapitelidentifieringen beskrivs i Strukturdetektering ovan. Markera Lägg inte till upptäckta kapitel i innehållsförteckningen om de identifierade kapitlen inte ska tas med.
Om färre kapitel än värdet i Kapiteltröskel identifieras lägger calibre till hyperlänkar från inmatningsdokumentet i innehållsförteckningen. Det fungerar ofta bra eftersom många dokument börjar med en länkad innehållsförteckning. Med Antal länkar att lägga till i innehållsförteckningen styr du hur många länkar som får läggas till. Värdet noll innebär inga länkar. Ett positivt tal anger det högsta antalet.
calibre filtrerar automatiskt bort dubbletter från den genererade innehållsförteckningen. Andra oönskade poster kan filtreras med Innehållsförteckningsfilter. Det är ett reguljärt uttryck som matchas mot posternas titlar. Poster vars titel matchar tas bort. För att till exempel ta bort alla poster med titeln ”Next” eller ”Previous” använder du:
Next|Previous
Alternativen Nivå 1,2,3 innehållsförteckning låter dig skapa en sofistikerad innehållsförteckning på flera nivåer. De är XPath-uttryck som matchar taggar i den mellanliggande XHTML som produceras av konverteringsprocessen. Se Introduktion för hur du får tillgång till denna XHTML. Läs också XPath-introduktion, för att lära dig hur man konstruerar XPath-uttryck. Bredvid varje alternativ finns en knapp som startar en guide som hjälper dig att skapa grundläggande XPath-uttryck. Följande enkla exempel illustrerar hur du använder de här alternativen.
Anta att du har ett inmatningsdokument som resulterar i XHTML och ser ut så här:
<html xmlns="http://www.w3.org/1999/xhtml">
    <head>
        <title>Sample document</title>
    </head>
    <body>
        <h1>Chapter 1</h1>
        ...
        <h2>Section 1.1</h2>
        ...
        <h2>Section 1.2</h2>
        ...
        <h1>Chapter 2</h1>
        ...
        <h2>Section 2.1</h2>
        ...
    </body>
</html>
Sedan anger vi alternativ som:
Level 1 TOC : //h:h1
Level 2 TOC : //h:h2
Detta kommer att resultera i en automatiskt genererad innehållsförteckning på två nivåer som ser ut som:
Chapter 1
    Section 1.1
    Section 1.2
Chapter 2
    Section 2.1
Varning
Inte alla utmatningsformat stöder en innehållsförteckning med flera nivåer. Du bör först försöka med EPUB-utmatning. Om det fungerar, testa sedan ditt val av format.
Använda bilder som kapitelrubriker vid konvertering av HTML-inmatningsdokument
Anta att du vill använda en bild som din kapitelrubrik, men ändå vill att calibre automatiskt ska kunna skapa en innehållsförteckning åt dig från kapitelrubrikerna. Använd följande HTML-markering för att uppnå detta:
<html>
    <body>
        <h2>Chapter 1</h2>
        <p>chapter 1 text...</p>
        <h2 title="Chapter 2"><img src="chapter2.jpg" /></h2>
        <p>chapter 2 text...</p>
    </body>
</html>
Ställ in inställningen Nivå 1 innehållsförteckning (XPath-uttryck) till //h:h2. Då, i kapitel två, tar calibre titeln från värdet av attributet title på <h2>-taggen, eftersom taggen inte har någon text.
Använda taggattribut för att leverera texten för posterna i innehållsförteckningen
Om du har särskilt långa kapiteltitlar och vill ha förkortade versioner i innehållsförteckningen kan du använda attributet title för att uppnå detta, till exempel:
<html>
    <body>
        <h2 title="Chapter 1">Chapter 1: Some very long title</h2>
        <p>chapter 1 text...</p>
        <h2 title="Chapter 2">Chapter 2: Some other very long title</h2>
        <p>chapter 2 text...</p>
    </body>
</html>
Ange //h:h2/@title för inställningen Nivå 1 innehållsförteckning (XPath-uttryck). calibre hämtar då titeln från värdet i attributet title på <h2>-taggarna i stället för från texten inuti taggen. Observera det avslutande /@title i XPath-uttrycket. Den här formen kan användas för att hämta text från valfritt attribut.
Hur alternativ ställs in/sparas för konvertering
Det finns två ställen där konverteringsalternativ kan ställas in i calibre. Den första är i Inställningar->Konvertering. Dessa inställningar är standardinställningarna för konverteringsalternativen. Varje gång du försöker konvertera en ny bok kommer inställningarna här att användas som standard.
Du kan även ändra inställningarna i dialogrutan för varje enskild konvertering. calibre kommer ihåg vilka inställningar som användes för boken. Vid nästa konvertering har de sparade inställningarna företräde framför standardvärdena i Inställningar. Återställ dem med knappen Återställ standardvärden i bokens konverteringsdialogruta. Om du vill ta bort sparade inställningar för flera böcker markerar du böckerna och klickar på Redigera metadata. I dialogrutan för massredigering av metadata finns ett alternativ nära botten som tar bort lagrade konverteringsinställningar.
När du masskonverterar en uppsättning böcker, tas inställningarna i följande ordning (sista vinner):
Från standardinställningarna i Inställningar->Konvertering
Från eventuella sparade konverteringsinställningar för varje bok. Detta kan stängas av med alternativet längst upp till vänster i dialogrutan för masskonvertering.
Från inställningarna i masskonverteringsdialogrutan
De slutliga inställningarna för varje bok i en masskonvertering sparas och återanvänds om boken konverteras igen. Inställningarna i masskonverteringsdialogrutan har högst prioritet och åsidosätter därför bokens egna inställningar. Masskonvertera bara böcker som behöver liknande inställningar tillsammans. Undantagen är metadata och inställningar för specifika inmatningsformat. Eftersom dessa inte finns i masskonverteringsdialogrutan hämtas de från bokens sparade inställningar, om sådana finns, eller från standardvärdena.
Anteckning
Du kan se de faktiska inställningarna som används under en konvertering genom att klicka på den roterande ikonen i det nedre högra hörnet och sedan dubbelklicka på det enskilda konverteringsjobbet. Detta kommer att ta upp en konverteringslogg som innehåller de faktiska inställningarna som används, nära toppen.
Formatspecifika tips
Här hittar du tips som är specifika för konvertering av vissa format. Alternativ specifika för visst format, oavsett inmatning eller utmatning finns i dialogrutan konvertering under eget avsnitt, till exempel TXT-inmatning eller EPUB-utmatning.
Konvertera Microsoft Word-dokument
calibre kan automatiskt konvertera .docx-filer som skapats av Microsoft Word 2007 och nyare. Lägg bara till filen i calibre och klicka på konvertera.
Anteckning
Det finns en demo .docx-fil som demonstrerar förmågorna hos calibres konverteringsmotor. Bara hämta den och konvertera den till EPUB eller AZW3 för att se vad calibre kan göra.
calibre skapar automatiskt en innehållsförteckning utifrån rubrikerna om du formaterar dina rubriker med formatmallarna Rubrik 1, Rubrik 2 osv. i Microsoft Word. Öppna den skapade e-boken i calibres e-bokvisare och klicka på knappen Innehållsförteckning för att visa innehållsförteckningen.
Äldre .doc-filer
För äldre .doc-filer kan du spara dokumentet som HTML med Microsoft Word och sedan konvertera den resulterande HTML-filen med calibre. När du sparar som HTML, se till att använda alternativet ”Spara som webbsida, filtrerad” eftersom detta kommer att producera ren HTML som kommer att konverteras bra. Observera att Word producerar en riktigt rörig HTML, att konvertera den kan ta lång tid, så ha tålamod. Om du har en nyare version av Word tillgänglig kan du också spara den direkt som .docx.
Ett annat alternativ är att använda gratis LibreOffice. Öppna din .doc-fil i LibreOffice och spara den som .docx, som direkt kan konverteras i calibre.
Konvertera TXT-dokument
TXT-dokument har inget väl definierat sätt att specificera formatering som fetstil, kursiv, etc., eller dokumentstruktur som stycken, rubriker, avsnitt och så vidare, men det finns en mängd konventioner som vanligtvis används. Som standard försöker calibre automatisk upptäcka korrekt formatering och markering baserat på dessa konventioner.
TXT-inmatning stöder ett antal alternativ för att differentiera hur stycken upptäcks.
- Styckeformat: Auto
Analyserar textfilen och försöker automatiskt avgöra hur styckena avgränsas. Detta fungerar vanligtvis bra. Om resultatet inte blir som du vill kan du prova ett manuellt alternativ.
- Styckeformat: Block
Förutsätter att en eller flera tomma rader utgör en styckesgräns:
This is the first. This is the second paragraph.- Styckeformat: Single
Förutsätter att varje rad är ett stycke:
This is the first. This is the second. This is the third.- Styckeformat: Print
Förutsätter att varje stycke börjar med ett indrag, antingen en tabulator eller minst två blanksteg. Stycket slutar vid nästa rad som börjar med ett indrag:
This is the first. This is the second. This is the third.- Styckeformat: Unformatted
Förutsätter att dokumentet inte har någon formatering, men använder hårda radbrytningar. Skiljetecken och medianradslängd används för att försöka återskapa stycken.
- Formateringsformat: Auto
Försöker identifiera vilken typ av uppmärkning för formatering som används. Om ingen uppmärkning finns används heuristisk formatering.
- Formateringsformat: Heuristic
Analyserar dokumentet för vanliga kapitelrubriker, scenbrytningar och kursiverade ord och tillämpar lämplig HTML-markering under konvertering.
- Formateringsformat: Markdown
calibre kan också förbehandla TXT-inmatning med Markdown. Det gör det möjligt att lägga till grundläggande formatering i TXT-dokument, till exempel fetstil, kursiv stil, avsnittsrubriker, tabeller, listor och en innehållsförteckning. Det enklaste sättet att skapa en korrekt innehållsförteckning från ett TXT-dokument är att inleda kapitelrubrikerna med # och ange ”//h:h1” som XPath-uttryck för kapitelidentifiering. Läs mer om Markdown-syntaxen på daringfireball.
- Formateringsformat: None
Ingen särskild formatering tillämpas. Dokumentet konverteras till HTML utan andra ändringar.
Konvertera PDF-dokument
PDF är ett av de svåraste formaten att konvertera från. Sidstorlek och textplacering är fasta, vilket gör det svårt att avgöra var ett stycke slutar och nästa börjar. calibre försöker ta bort radbrytningarna i styckena med hjälp av inställningen Faktor för borttagning av radbrytningar. Den anger en gräns för vilka radlängder som ska behandlas. Giltiga värden är decimaltal mellan 0 och 1. Standardvärdet är 0,45, strax under medianradlängden. Sänk värdet för att bearbeta mer text och höj det för att bearbeta mindre. Inställningen finns under PDF-inmatning i konverteringsdialogrutan.
PDF-dokument innehåller ofta sidhuvuden och sidfötter som följer med in i texten vid konvertering. Använd panelen Sök och ersätt för att ta bort dem. Om de lämnas kvar kan de störa borttagningen av radbrytningar inom stycken. Läs Allt om att använda reguljära uttryck i calibre för att lära dig använda alternativen för att ta bort sidhuvuden och sidfötter.
Vissa begränsningar på PDF-inmatning är:
Komplexa, flerkolumn- och bildbaserade dokument stöds inte.
Det finns inte heller stöd för att extrahera vektorbilder och tabeller ur dokumentet.
Vissa PDF-filer använder speciella glyfer för att representera ll eller ff eller fi etc. Konvertering av dessa kanske eller kanske inte fungerar beroende på hur de representeras internt i PDF:en.
Länkar och innehållsförteckning stöds inte
PDF-filer som använder inbäddade teckensnitt utan Unicode för att återge icke-engelska tecken ger felaktiga tecken i utmatningen
Vissa PDF-filer är uppbyggda av fotografier av sidan med OCR-text bakom dem. I sådana fall använder calibre OCR-texten, vilket kan vara mycket annorlunda från vad du ser när du visar PDF-filen
PDF-filer med komplex text, till exempel språk som skrivs från höger till vänster eller matematisk sättning, konverteras inte korrekt
För att upprepa: PDF är ett riktigt, riktigt dåligt inmatningsformat. Om du måste använda PDF behöver du vara beredd på allt från ett acceptabelt till ett oanvändbart resultat, beroende på källfilen.
Serietidningssamlingar
En serietidningssamling är en .cbc-fil: en ZIP-fil som innehåller CBZ- eller CBR-filer. Den måste också innehålla en vanlig textfil med namnet comics.txt, kodad i UTF-8. Där ska filerna i samlingen räknas upp i formen filename:title, enligt nedan:
one.cbz:Chapter One
two.cbz:Chapter Two
three.cbz:Chapter Three
.cbc-filen kommer då innehålla:
comics.txt
one.cbz
two.cbz
three.cbz
calibre kommer automatiskt att konvertera denna .cbc-fil till en e-bok med en innehållsförteckning som pekar på varje post i comics.txt.
Demonstration av avancerad EPUB-formatering
Den här demofilen visar olika former av avancerad EPUB-formatering. Den skapades från handskriven HTML med calibre och är tänkt som mall för när du skapar egna EPUB-filer.
HTML-källan som den skapades från är tillgänglig demo.zip. Inställningarna som används för att skapa EPUB:en från ZIP-filen är:
ebook-convert demo.zip .epub -vv --authors "Kovid Goyal" --language en --level1-toc '//*[@class="title"]' --disable-font-rescaling --page-breaks-before / --no-default-epub-cover
Filen demonstrerar EPUB-formatets möjligheter. Det mesta av den avancerade formateringen fungerar därför inte på läsare som har mer begränsat stöd än calibres inbyggda EPUB-visare.
Konvertera ODT-dokument
calibre kan konvertera ODT-filer (OpenDocument Text) direkt. Använd formatmallar för att formatera dokumentet och undvik direktformatering så långt som möjligt. När du infogar bilder behöver du förankra dem i stycket. Bilder som förankras i en sida hamnar annars alla i början av den konverterade boken.
För att kapitel ska identifieras automatiskt måste du använda de inbyggda formatmallarna Rubrik 1, Rubrik 2, …, Rubrik 6. Rubrik 1 motsvarar HTML-taggen <h1>, Rubrik 2 motsvarar <h2> och så vidare. När du konverterar i calibre anger du vilken formatmall du använde i rutan Identifiera kapitel med (XPath-uttryck). Exempel:
Om du använder formatmallen Rubrik 2 för kapitelrubrikerna ska du ange
//h:h2i rutan ”Identifiera kapitel med (XPath-uttryck)”För en innehållsförteckning med flera nivåer där avsnitten använder Rubrik 2 och kapitlen Rubrik 3 anger du
//h:h2|//h:h3. På sidan Innehållsförteckning i konverteringsdialogrutan anger du//h:h2i Nivå 1 innehållsförteckning (XPath-uttryck) och//h:h3i Nivå 2 innehållsförteckning (XPath-uttryck).
Välkända dokumentegenskaper (titel, nyckelord, beskrivning, skapare) känns igen och calibre kommer att använda den första bilden (inte för liten och med bra bildförhållande) som omslagsbild.
Det finns också ett avancerat egenskapskonverteringsläge, som aktiveras genom att ställa in den anpassade egenskapen opf.metadata (av ”Ja eller Nej” typ) till Ja i ditt ODT-dokument (Arkiv->Egenskaper->Anpassa egenskaper). Om den här egenskapen upptäcks av calibre känns följande anpassade egenskaper igen (opf.authors åsidosätter dokumentets skapare):
opf.titlesort
opf.authors
opf.authorsort
opf.publisher
opf.pubdate
opf.isbn
opf.language
opf.series
opf.seriesindex
Du kan också ange omslagsbilden genom att ge den namnet opf.cover i ODT-dokumentet (högerklicka och välj Bild->Alternativ->Namn). Om ingen bild med det namnet hittas används den ”smarta” metoden. Eftersom omslagsidentifieringen kan ge dubbla omslag i vissa utmatningsformat tas stycket bort ur dokumentet, men endast om omslaget är dess enda innehåll. Detta fungerar bara med den namngivna bilden!
För att inaktivera omslagsupptäckt kan du ställa in den anpassade egenskapen opf.nocover (’Ja eller Nej’-typ) till Ja i avancerat läge.
Konvertera till PDF
Den första och viktigaste inställningen vid konvertering till PDF är sidstorleken. Standardvärdet i calibre är ”U.S. Letter”. Under PDF-utmatning i konverteringsdialogrutan kan du välja en annan standardstorlek eller ange en egen. Om PDF-filen är avsedd för en viss enhet kan du i stället aktivera alternativet som använder sidstorleken från Utmatningsprofil. Med Kindle som utmatningsprofil skapar calibre då en PDF med en sidstorlek som passar den lilla Kindle-skärmen.
Utskrivbar innehållsförteckning
Du kan också infoga en utskrivbar innehållsförteckning i slutet av PDF-filen med sidnummer för varje avsnitt. Det är användbart om du vill skriva ut filen på papper. Vid läsning på en elektronisk enhet fyller PDF-dispositionen samma funktion och skapas som standard.
Du kan anpassa den genererade innehållsförteckningens utseende med inställningen Extra CSS under Utseende och känsla i konverteringsdialogrutan. Standardkoden för CSS visas nedan. Kopiera den och gör de ändringar du vill.
.calibre-pdf-toc table { width: 100%% }

.calibre-pdf-toc table tr td:last-of-type { text-align: right }

.calibre-pdf-toc .level-0 {
    font-size: larger;
}

.calibre-pdf-toc .level-1 td:first-of-type { padding-left: 1.4em }
.calibre-pdf-toc .level-2 td:first-of-type { padding-left: 2.8em }
Anpassade sidmarginaler för enskilda HTML-filer
Om du konverterar en EPUB- eller AZW3-fil som innehåller flera HTML-filer kan du ändra sidmarginalerna för en viss fil genom att lägga till följande stilblock med calibres e-boksredigerare:
<style>
@page {
    margin-left: 10pt;
    margin-right: 10pt;
    margin-top: 10pt;
    margin-bottom: 10pt;
}
</style>
Aktivera sedan alternativet Använd sidmarginaler från dokumentet som konverteras i PDF-utmatningsavsnittet av konverteringsdialogrutan. Nu kommer alla sidor som genereras från denna HTML-fil att ha 10pt marginaler.