 Promeni jezik
Režim funkcije za pretragu i zamenu u uređivaču
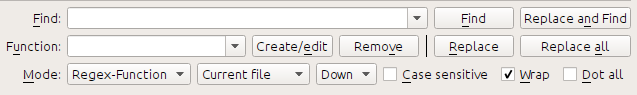
Alat Search & replace u uređivaču podržava funkcijski režim. U ovom režimu možete kombinovati regularne izraze (pogledajte Sve o korišćenju regularnih izraza u programu calibre) sa proizvoljno moćnim Python funkcijama za obavljanje svih vrsta napredne obrade teksta.
U standardnom regexp režimu za pretragu i zamenu, navodite i regularni izraz za pretragu i šablon koji se koristi za zamenu svih pronađenih poklapanja. U funkcijskom režimu, umesto korišćenja fiksnog šablona, navodite proizvoljnu funkciju u Python programskom jeziku. Ovo vam omogućava da radite mnoge stvari koje nisu moguće sa jednostavnim šablonima.
Tehnike za korišćenje funkcijskog režima i sintaksa biće opisane pomoću primera, pokazujući vam kako da kreirate funkcije za obavljanje progresivno složenijih zadataka.
Automatsko popravljanje veličine slova naslova u dokumentu
Ovde ćemo upotrebiti ugrađenu funkciju uređivača koja automatski postavlja velika početna slova u tekstu unutar oznaka naslova:
Find expression: <([Hh][1-6])[^>]*>.+?</\1>
Za funkciju izaberite ugrađenu funkciju Title-case text (ignore tags). Ona će naslove poput <h1>some titLE</h1> promeniti u <h1>Some Title</h1>. Radiće i kada se unutar naslova nalaze druge HTML oznake.
Vaša prva prilagođena funkcija - pametne crtice
Prava moć funkcijskog režima dolazi od mogućnosti kreiranja sopstvenih funkcija za obradu teksta na proizvoljne načine. Alat Smarten Punctuation u uređivaču ostavlja pojedinačne crtice na miru, tako da možete koristiti ovu funkciju da ih zamenite em-crticama.
Da biste kreirali novu funkciju, jednostavno kliknite na dugme Create/edit da kreirate novu funkciju i kopirate Python kod ispod.
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    return match.group().replace('--', '—').replace('-', '—')
Svaka Search & replace prilagođena funkcija mora imati jedinstveno ime i sastojati se od Python funkcije pod nazivom replace, koja prihvata sve gore prikazane argumente. Za sada, nećemo brinuti o svim različitim argumentima za funkciju replace(). Samo se fokusirajte na argument match. On predstavlja poklapanje prilikom pokretanja pretrage i zamene. Njegova puna dokumentacija je dostupna ovde. match.group() jednostavno vraća sav poklopljeni tekst i sve što radimo je da zamenimo crtice u tom tekstu sa em-crticama, prvo zamenjujući dvostruke crtice, a zatim jednostruke crtice.
Koristite ovu funkciju sa regularnim izrazom za pronalaženje:
>[^<>]+<
I to će zameniti sve crtice sa em-crticama, ali samo u stvarnom tekstu, a ne unutar definicija HTML oznaka.
Moć režima funkcije — ispravljanje pogrešno rastavljenih reči pomoću pravopisnog rečnika
Često, e-knjige kreirane iz skeniranih štampanih knjiga sadrže pogrešno rastavljene reči -- reči koje su bile podeljene na kraju reda na štampanoj stranici. Napisaćemo jednostavnu funkciju da automatski pronađemo i popravimo takve reči.
import regex
from calibre import replace_entities
from calibre import prepare_string_for_xml

def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):

    def replace_word(wmatch):
        # Try to remove the hyphen and replace the words if the resulting
        # hyphen free word is recognized by the dictionary
        without_hyphen = wmatch.group(1) + wmatch.group(2)
        if dictionaries.recognized(without_hyphen):
            return without_hyphen
        return wmatch.group()

    # Search for words split by a hyphen
    text = replace_entities(match.group()[1:-1])  # Handle HTML entities like &
    corrected = regex.sub(r'(\w+)\s*-\s*(\w+)', replace_word, text, flags=regex.VERSION1 | regex.UNICODE)
    return '>%s<' % prepare_string_for_xml(corrected)  # Put back required entities
Koristite ovu funkciju sa istim izrazom za pronalaženje kao i ranije, naime:
>[^<>]+<
I to će magično popraviti sve pogrešno rastavljene reči u tekstu knjige. Glavni trik je da koristite jedan od korisnih dodatnih argumenata za funkciju replace, dictionaries. Ovo se odnosi na rečnike koje sam uređivač koristi za proveru pravopisa teksta u knjizi. Ono što ova funkcija radi je da traži reči razdvojene crticom, uklanja crticu i proverava da li rečnik prepoznaje složenu reč, ako je prepoznaje, originalne reči se zamenjuju složenom rečju bez crtice.
Imajte na umu da je jedno ograničenje ove tehnike to što će raditi samo za jednojezične knjige, jer, podrazumevano, dictionaries.recognized() koristi glavni jezik knjige.
Automatsko numerisanje sekcija
Sada ćemo videti nešto drugačije. Pretpostavimo da HTML fajl ima mnogo odeljaka, od kojih svaki ima naslov u oznaci <h2>, poput <h2>Some text</h2>. Možete napraviti prilagođenu funkciju koja će tim naslovima automatski dodati redne brojeve odeljaka, tako da izgledaju kao <h2>1. Some text</h2>.
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    section_number = '%d. ' % number
    return match.group(1) + section_number + match.group(2)

# Ensure that when running over multiple files, the files are processed
# in the order in which they appear in the book
replace.file_order = 'spine'
Koristite ga sa izrazom za pretragu:
(?s)(<h2[^<>]*>)(.+?</h2>)
Postavite kursor na vrh datoteke i kliknite na Zameni sve.
Ova funkcija koristi još jedan od korisnih dodatnih argumenata za replace(): argument number. Prilikom izvođenja Zameni sve broj se automatski povećava za svako uzastopno podudaranje.
Još jedna nova funkcija je upotreba replace.file_order -- postavljanje na 'spine' znači da ako se ova pretraga pokrene na više HTML datoteka, datoteke se obrađuju redosledom kojim se pojavljuju u knjizi. Pogledajte Izaberite redosled datoteka kada se pokreće na više HTML datoteka za detalje.
Automatsko kreiranje sadržaja
Na kraju, pokušajmo nešto zahtevnije. Pretpostavimo da knjiga ima naslove u oznakama h1 i h2 poput <h1 id="someid">Some Text</h1>. Na osnovu njih ćemo automatski napraviti HTML sadržaj. Napravite prilagođenu funkciju prikazanu ispod:
from calibre import replace_entities
from calibre.ebooks.oeb.polish.toc import TOC, toc_to_html
from calibre.gui2.tweak_book import current_container
from calibre.ebooks.oeb.base import xml2str

def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    if match is None:
        # All matches found, output the resulting Table of Contents.
        # The argument metadata is the metadata of the book being edited
        if 'toc' in data:
            toc = data['toc']
            root = TOC()
            for (file_name, tag_name, anchor, text) in toc:
                parent = root.children[-1] if tag_name == 'h2' and root.children else root
                parent.add(text, file_name, anchor)
            toc = toc_to_html(root, current_container(), 'toc.html', 'Table of Contents for ' + metadata.title, metadata.language)
            print(xml2str(toc))
        else:
            print('No headings to build ToC from found')
    else:
        # Add an entry corresponding to this match to the Table of Contents
        if 'toc' not in data:
            # The entries are stored in the data object, which will persist
            # for all invocations of this function during a 'Replace All' operation
            data['toc'] = []
        tag_name, anchor, text = match.group(1), replace_entities(match.group(2)), replace_entities(match.group(3))
        data['toc'].append((file_name, tag_name, anchor, text))
        return match.group()  # We don't want to make any actual changes, so return the original matched text

# Ensure that we are called once after the last match is found so we can
# output the ToC
replace.call_after_last_match = True
# Ensure that when running over multiple files, this function is called,
# the files are processed in the order in which they appear in the book
replace.file_order = 'spine'
I koristite ga sa izrazom za pretragu:
<(h[12]) [^<>]* id=['"]([^'"]+)['"][^<>]*>([^<>]+)
Pokrenite pretragu na Sve tekstualne datoteke i na kraju pretrage, iskočiće prozor sa "Izlaz za otklanjanje grešaka iz vaše funkcije" koji će imati HTML sadržaj, spreman da se nalepi u toc.html.
Funkcija iznad je detaljno komentarisana, tako da bi trebalo da bude laka za praćenje. Ključna nova funkcija je upotreba još jednog korisnog dodatnog argumenta za funkciju replace(), objekta data. Objekat data je Python rečnik koji opstaje između svih uzastopnih pozivanja replace() tokom jedne operacije Zameni sve.
Još jedna nova funkcija je upotreba call_after_last_match -- postavljanje toga na True u funkciji replace() znači da će uređivač pozvati replace() još jednom nakon što su sva poklapanja pronađena. Za ovaj dodatni poziv, objekat poklapanja će biti None.
Ovo je bila samo demonstracija da vam pokaže moć režima funkcije, ako vam je zaista potrebno da generišete Sadržaj iz naslova u vašoj knjizi, bilo bi vam bolje da koristite namenski alat za Sadržaj u Tools → Table of Contents.
API za režim funkcije
Sve funkcije režima funkcije moraju biti Python funkcije sa imenom replace, sa sledećim potpisom:
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    return a_string
Kada se pokrene pretraga/zamena, za svako pronađeno poklapanje, funkcija replace() će biti pozvana, ona mora vratiti string za zamenu za to poklapanje. Ako ne treba vršiti zamene, trebalo bi da vrati match.group() što je originalni string. Različiti argumenti za funkciju replace() su dokumentovani ispod.
Argument match
Argument match predstavlja trenutno pronađeno poklapanje. To je Python Match objekat. Njegov najkorisniji metod je group() koji se može koristiti za dobijanje poklopljenog teksta koji odgovara pojedinačnim grupama za hvatanje u regularnom izrazu pretrage.
Argument number
Argument number je broj trenutnog poklapanja. Kada pokrenete Replace All, svako uzastopno poklapanje će izazvati pozivanje replace() sa rastućim brojem. Prvo poklapanje ima broj 1.
Argument file_name
Ovo je ime datoteke u kojoj je pronađeno trenutno poklapanje. Prilikom pretrage unutar označenog teksta, file_name je prazno. file_name je u kanonskom obliku, putanja relativna u odnosu na koren knjige, koristeći / kao separator putanje.
Argument metadata
Ovo predstavlja metapodatke trenutne knjige, kao što su naslov, autori, jezik, itd. To je objekat klase calibre.ebooks.metadata.book.base.Metadata. Korisni atributi uključuju title, authors (lista autora) i language (kod jezika).
Argument dictionaries
Ovo predstavlja kolekciju rečnika koji se koriste za proveru pravopisa trenutne knjige. Njegov najkorisniji metod je dictionaries.recognized(word) koji će vratiti True ako je prosleđena reč prepoznata od strane rečnika za jezik trenutne knjige.
Argument data
Ovo je jednostavan Python dictionary. Kada pokrenete Replace all, svako uzastopno poklapanje će izazvati pozivanje replace() sa istim dictionary kao podacima. Tako ga možete koristiti za čuvanje proizvoljnih podataka između poziva replace() tokom operacije Replace all.
Argument functions
Argument functions vam daje pristup svim ostalim korisnički definisanim funkcijama. Ovo je korisno za ponovnu upotrebu koda. Možete definisati uslužne funkcije na jednom mestu i ponovo ih koristiti u svim ostalim funkcijama. Na primer, pretpostavimo da kreirate funkciju pod nazivom My Function ovako:
def utility():
   # do something

def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    ...
Zatim, u drugoj funkciji, možete pristupiti funkciji utility() ovako:
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    utility = functions['My Function']['utility']
    ...
Takođe možete koristiti objekat funkcija za čuvanje trajnih podataka, koji se mogu ponovo koristiti u drugim funkcijama. Na primer, možete imati jednu funkciju koja kada se pokrene sa Replace All prikuplja neke podatke i drugu funkciju koja ih koristi kada se pokrene nakon toga. Razmotrite sledeće dve funkcije:
# Function One
persistent_data = {}

def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    ...
    persistent_data['something'] = 'some data'

# Function Two
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    persistent_data = functions['Function One']['persistent_data']
    ...
Otklanjanje grešaka u vašim funkcijama
Možete otklanjati greške u funkcijama koje kreirate koristeći standardnu print() funkciju iz Python-a. Izlaz print-a će biti prikazan u iskačućem prozoru nakon što se Find/replace završi. Videli ste primer korišćenja print() za ispis celog sadržaja iznad.
Izaberite redosled datoteka kada se pokreće na više HTML datoteka
Kada pokrenete Replace all na više HTML datoteka, redosled kojim se datoteke obrađuju zavisi od toga koje datoteke imate otvorene za uređivanje. Možete prisiliti pretragu da obrađuje datoteke redosledom kojim se pojavljuju postavljanjem atributa file_order na vašoj funkciji, ovako:
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    ...

replace.file_order = 'spine'
file_order prihvata dve vrednosti, spine i spine-reverse koje uzrokuju da pretraga obrađuje više datoteka redosledom kojim se pojavljuju u knjizi, unapred ili unazad, respektivno.
Pozivanje vaše funkcije dodatni put nakon što se pronađe poslednje podudaranje
Ponekad, kao u primeru automatskog generisanja sadržaja iznad, korisno je da se vaša funkcija pozove dodatni put nakon što se pronađe poslednje podudaranje. To možete učiniti postavljanjem atributa call_after_last_match na vašoj funkciji, ovako:
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    ...

replace.call_after_last_match = True
Dodavanje izlaza iz funkcije označenom tekstu
Kada pokrećete pretragu i zamenu na označenom tekstu, ponekad je korisno dodati neki tekst na kraj označenog teksta. To možete učiniti postavljanjem atributa append_final_output_to_marked na vašoj funkciji (imajte na umu da takođe morate postaviti call_after_last_match), ovako:
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    ...
    return 'some text to append'

replace.call_after_last_match = True
replace.append_final_output_to_marked = True
Potiskivanje dijaloga sa rezultatima prilikom pretrage označenog teksta
Takođe možete potisnuti dijalog sa rezultatima (koji može usporiti ponovljenu primenu pretrage/zamene na mnogim blokovima teksta) postavljanjem atributa suppress_result_dialog na vašoj funkciji, ovako:
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    ...

replace.suppress_result_dialog = True
Više primera
Više korisnih primera, koje su doprineli korisnici calibre-a, može se naći na calibre E-book editor forumu.