 Ändra språk
Funktionsläge för Sök & ersätt i redigeraren
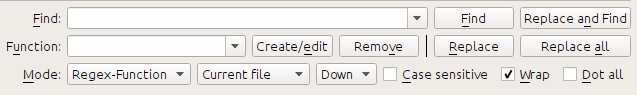
Verktyget Sök & ersätt i redigeraren stöder ett funktionsläge. I det här läget kan du kombinera reguljära uttryck (se Allt om att använda reguljära uttryck i calibre) med Python-funktioner av valfri komplexitet för att utföra alla möjliga slags avancerad textbehandling.
I standardläget regexp för sök och ersätt anger du både ett reguljärt sökuttryck och en mall som används för att ersätta alla hittade träffar. I funktionsläget anger du i stället för en fast mall en valfri funktion i programmeringsspråket Python. Det gör det möjligt att utföra många uppgifter som inte går att lösa med enkla mallar.
Tekniker för att använda funktionsläge och syntaxen beskrivs med hjälp av exempel, som visar dig hur du skapar funktioner för att utföra allt mer komplexa uppgifter.
Justera automatiskt skiftläget i dokumentets rubriker
Här använder vi en av redigerarens inbyggda funktioner för att automatiskt ändra texten i alla rubriktaggar till inledande versaler:
Find expression: <([Hh][1-6])[^>]*>.+?</\1>
Välj den inbyggda funktionen Title-case text (ignore tags). Den ändrar rubriker som <h1>some titLE</h1> till <h1>Some Title</h1>. Det fungerar även om rubriktaggarna innehåller andra HTML-taggar.
Din första anpassade funktion – förbättra bindestreck
Den verkliga styrkan i funktionsläget är möjligheten att skapa egna funktioner som bearbetar text på valfria sätt. Verktyget Förbättra skiljetecken i redigeraren lämnar enskilda bindestreck oförändrade, så du kan använda den här funktionen för att ersätta dem med långa tankstreck.
Skapa en ny funktion genom att klicka på knappen Skapa/redigera och kopiera Python-koden nedan.
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    return match.group().replace('--', '—').replace('-', '—')
Varje anpassad funktion för Sök & ersätt måste ha ett unikt namn och bestå av en Python-funktion med namnet replace som tar emot alla argument som visas ovan. För tillfället behöver vi inte gå igenom alla argument till funktionen replace(). Fokusera på argumentet match. Det representerar en träff när du söker och ersätter. Fullständig dokumentation finns här. match.group() returnerar all matchad text. Det enda vi gör är att ersätta bindestreck i den texten med långa tankstreck: först dubbla bindestreck och sedan enkla.
Använd funktionen med följande reguljära sökuttryck:
>[^<>]+<
Då ersätts alla bindestreck med långa tankstreck, men bara i själva texten och inte inuti HTML-taggdefinitioner.
Funktionslägets möjligheter – rätta felaktigt avstavade ord med en stavningsordbok
E-böcker som skapats genom att skanna tryckta böcker innehåller ofta felaktigt avstavade ord – ord som delades vid radslutet på den tryckta sidan. Vi ska skriva en enkel funktion som automatiskt hittar och rättar sådana ord.
import regex
from calibre import replace_entities
from calibre import prepare_string_for_xml

def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):

    def replace_word(wmatch):
        # Try to remove the hyphen and replace the words if the resulting
        # hyphen free word is recognized by the dictionary
        without_hyphen = wmatch.group(1) + wmatch.group(2)
        if dictionaries.recognized(without_hyphen):
            return without_hyphen
        return wmatch.group()

    # Search for words split by a hyphen
    text = replace_entities(match.group()[1:-1])  # Handle HTML entities like &
    corrected = regex.sub(r'(\w+)\s*-\s*(\w+)', replace_word, text, flags=regex.VERSION1 | regex.UNICODE)
    return '>%s<' % prepare_string_for_xml(corrected)  # Put back required entities
Använd denna funktion med samma sökuttryck som tidigare, det vill säga:
>[^<>]+<
Då rättas alla felaktigt avstavade ord i bokens text som genom ett trollslag. Knepet är att använda ett av de användbara extraargumenten till funktionen replace: dictionaries. Det avser de ordböcker som redigeraren själv använder för att stavningskontrollera bokens text. Funktionen letar efter ord som skiljs åt av ett bindestreck, tar bort bindestrecket och kontrollerar om ordboken känner igen det sammansatta ordet. Om den gör det ersätts de ursprungliga orden med det sammansatta ordet utan bindestreck.
Observera att en begränsning av denna teknik är att den bara fungerar för enspråkiga böcker, eftersom dictionaries.recognized() som standard använder bokens huvudspråk.
Numrera avsnitt automatiskt
Nu ska vi se något lite annorlunda. Anta att din HTML-fil har många avsnitt, vart och ett med en rubrik i en <h2>-tagg som ser ut så här: <h2>Some text</h2>. Du kan skapa en anpassad funktion som automatiskt numrerar dessa rubriker med avsnittsnummer i följd, så att de ser ut så här: <h2>1. Some text</h2>.
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    section_number = '%d. ' % number
    return match.group(1) + section_number + match.group(2)

# Ensure that when running over multiple files, the files are processed
# in the order in which they appear in the book
replace.file_order = 'spine'
Använd det med sökuttrycket:
(?s)(<h2[^<>]*>)(.+?</h2>)
Placera markören överst i filen och klicka på Ersätt alla.
Den här funktionen använder ett annat av de användbara extraargumenten till replace(): argumentet number. När du kör Ersätt alla ökas numret automatiskt för varje efterföljande träff.
En annan nyhet är användningen av replace.file_order. Om du anger värdet 'spine' och kör sökningen på flera HTML-filer bearbetas filerna i den ordning de förekommer i boken. Se Välj filordning när flera HTML-filer bearbetas för detaljer.
Skapa automatiskt en innehållsförteckning
Låt oss slutligen prova något lite mer ambitiöst. Anta att boken har rubriker i taggarna h1 och h2 som ser ut så här: <h1 id="someid">Some Text</h1>. Vi ska automatiskt skapa en HTML-innehållsförteckning utifrån dessa rubriker. Skapa den anpassade funktionen nedan:
from calibre import replace_entities
from calibre.ebooks.oeb.polish.toc import TOC, toc_to_html
from calibre.gui2.tweak_book import current_container
from calibre.ebooks.oeb.base import xml2str

def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    if match is None:
        # All matches found, output the resulting Table of Contents.
        # The argument metadata is the metadata of the book being edited
        if 'toc' in data:
            toc = data['toc']
            root = TOC()
            for (file_name, tag_name, anchor, text) in toc:
                parent = root.children[-1] if tag_name == 'h2' and root.children else root
                parent.add(text, file_name, anchor)
            toc = toc_to_html(root, current_container(), 'toc.html', 'Table of Contents for ' + metadata.title, metadata.language)
            print(xml2str(toc))
        else:
            print('No headings to build ToC from found')
    else:
        # Add an entry corresponding to this match to the Table of Contents
        if 'toc' not in data:
            # The entries are stored in the data object, which will persist
            # for all invocations of this function during a 'Replace All' operation
            data['toc'] = []
        tag_name, anchor, text = match.group(1), replace_entities(match.group(2)), replace_entities(match.group(3))
        data['toc'].append((file_name, tag_name, anchor, text))
        return match.group()  # We don't want to make any actual changes, so return the original matched text

# Ensure that we are called once after the last match is found so we can
# output the ToC
replace.call_after_last_match = True
# Ensure that when running over multiple files, this function is called,
# the files are processed in the order in which they appear in the book
replace.file_order = 'spine'
Och använd den med sökuttrycket:
<(h[12]) [^<>]* id=['"]([^'"]+)['"][^<>]*>([^<>]+)
Kör sökningen på Alla textfiler. När sökningen är klar visas ett fönster med felsökningsutmatningen från din funktion. Det innehåller HTML-innehållsförteckningen, färdig att klistras in i toc.html.
Funktionen ovan är utförligt kommenterad och bör därför vara lätt att följa. Den viktigaste nyheten är användningen av ännu ett extraargument till funktionen replace(): objektet data. Objektet data är en Python-uppslagstabell som bevaras mellan alla efterföljande anrop av replace() under en och samma Ersätt alla-åtgärd.
En annan nyhet är användningen av call_after_last_match. Om detta attribut sätts till True på funktionen replace() anropar redigeraren replace() en extra gång efter att alla träffar har hittats. Vid detta extra anrop är träffobjektet None.
Det här var bara en demonstration av funktionslägets möjligheter. Om du faktiskt behöver skapa en innehållsförteckning från bokens rubriker är det bättre att använda det särskilda verktyget under Verktyg → Innehållsförteckning.
API för funktionsläget
Alla funktioner i funktionsläget måste vara Python-funktioner med namnet replace och följande signatur:
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    return a_string
När en sökning och ersättning körs anropas funktionen replace() för varje träff som hittas. Funktionen måste returnera ersättningssträngen för träffen. Om ingen ersättning ska göras ska den returnera match.group(), vilket är den ursprungliga strängen. De olika argumenten till funktionen replace() dokumenteras nedan.
Argumentet match
Argumentet match representerar den matchning som har hittats. Det är ett Python Match-objekt. Dess mest användbara metod är group(), som kan användas för att hämta den matchade text som motsvarar enskilda fångstgrupper i det reguljära sökuttrycket.
Argumentet number
Argumentet number är numret på den aktuella träffen. När du kör Ersätt alla anropas replace() med ett allt högre nummer för varje efterföljande träff. Den första träffen har nummer 1.
Argumentet file_name
Det här är filnamnet på filen där den aktuella träffen hittades. När du söker inuti markerad text är file_name tom. file_name är i kanonisk form, en relativ sökväg till roten av boken, med / som sökvägsavgränsare.
Argumentet metadata
Detta representerar den aktuella bokens metadata, såsom titel, författare och språk. Det är ett objekt av klassen calibre.ebooks.metadata.book.base.Metadata. Användbara attribut är bland annat title, authors (en lista med författare) och language (språkkoden).
Argumentet dictionaries
Detta representerar samlingen av ordböcker som används för att stavningskontrollera den aktuella boken. Dess mest användbara metod är dictionaries.recognized(word), som returnerar True om det angivna ordet känns igen av ordboken för bokens språk.
data-argumentet
Detta är en enkel uppslagstabell (dictionary) i Python. När du kör Ersätt alla anropas replace() för varje efterföljande träff med samma dictionary som data. Du kan därför använda den för att lagra valfria data mellan anrop av replace() under en Ersätt alla-åtgärd.
functions-argumentet
Argumentet functions ger dig åtkomst till alla andra användardefinierade funktioner. Det är användbart för återanvändning av kod. Du kan definiera hjälpfunktioner på ett ställe och återanvända dem i alla dina andra funktioner. Anta till exempel att du skapar en funktion med namnet My Function så här:
def utility():
   # do something

def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    ...
I en annan funktion kan du sedan komma åt funktionen utility() så här:
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    utility = functions['My Function']['utility']
    ...
Du kan också använda objektet functions för att lagra beständiga data som kan återanvändas av andra funktioner. Du kan till exempel ha en funktion som samlar in data när den körs med Ersätt alla och en annan funktion som använder dessa data när den körs efteråt. Betrakta följande två funktioner:
# Function One
persistent_data = {}

def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    ...
    persistent_data['something'] = 'some data'

# Function Two
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    persistent_data = functions['Function One']['persistent_data']
    ...
Felsökning av dina funktioner
Du kan felsöka funktionerna du skapar med Pythons standardfunktion print(). Utmatningen från print visas i ett extrafönster när sökningen och ersättningen är klar. Ovan såg du ett exempel där print() används för att mata ut en hel innehållsförteckning.
Välj filordning när flera HTML-filer bearbetas
När du kör Ersätt alla i flera HTML-filer beror filernas bearbetningsordning på vilka filer du har öppnat för redigering. Du kan tvinga sökningen att bearbeta filerna i den ordning de förekommer genom att ange attributet file_order för funktionen så här:
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    ...

replace.file_order = 'spine'
file_order kan ha två värden: spine och spine-reverse. De får sökningen att bearbeta filerna i bokens läsordning, framåt respektive bakåt.
Anropa funktionen en extra gång efter den sista träffen
Ibland är det användbart att anropa funktionen en extra gång efter att den sista träffen har hittats, som i exemplet ovan där en innehållsförteckning skapas automatiskt. Du kan göra detta genom att ange attributet call_after_last_match för funktionen så här:
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    ...

replace.call_after_last_match = True
Lägg till funktionens utmatning sist i den markerade texten
När du kör sök och ersätt på markerad text kan det ibland vara praktiskt att lägga till text i slutet av den markerade texten. Det kan du göra genom att ange attributet append_final_output_to_marked för funktionen (observera att du även måste ange call_after_last_match) så här:
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    ...
    return 'some text to append'

replace.call_after_last_match = True
replace.append_final_output_to_marked = True
Undertryck resultatdialogrutan vid sökning i markerad text
Du kan också undertrycka resultatdialogrutan, som kan sakta ner upprepade sökningar och ersättningar i många textblock, genom att ange attributet suppress_result_dialog för funktionen så här:
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    ...

replace.suppress_result_dialog = True
Fler exempel
Fler användbara exempel från calibre-användare finns i forumet för calibres e-bokredigerare.