 Zmeniť jazyk
Režim funkcie pre Hľadať a nahradiť v editore
Nástroj Hľadať a nahradiť v editore podporuje režim funkcie. V tomto režime môžete kombinovať regulárne výrazy (pozri Všetko o používaní regulárnych výrazov v calibre) s ľubovoľne výkonnými funkciami Pythonu na vykonávanie najrôznejšieho pokročilého spracovania textu.
V štandardnom režime regexp pre hľadanie a nahrádzanie zadávate regulárny výraz, ktorý sa má hľadať, aj šablónu, ktorá sa použije na nahradenie všetkých nájdených zhôd. V režime funkcie namiesto pevnej šablóny zadávate ľubovoľnú funkciu v programovacom jazyku Python. To vám umožňuje robiť mnoho vecí, ktoré s jednoduchými šablónami nie sú možné.
Techniky používania režimu funkcie a syntax budú opísané prostredníctvom príkladov, ktoré vám ukážu, ako vytvárať funkcie na vykonávanie postupne zložitejších úloh.
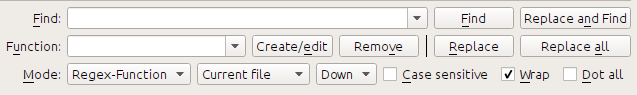
Automatická oprava veľkosti písmen v nadpisoch dokumentu
Tu využijeme jednu z vstavaných funkcií editora na automatickú zmenu veľkosti písmen všetkého textu vnútri značiek nadpisov na veľkosť písmen v nadpisoch:
Find expression: <([Hh][1-6])[^>]*>.+?</\1>
Ako funkciu jednoducho zvoľte vstavanú funkciu Text s veľkými písmenami v nadpisoch (ignorovať značky). Tá zmení nadpisy, ktoré vyzerajú ako: <h1>some titLE</h1>, na <h1>Some Title</h1>. Bude fungovať aj vtedy, ak sú vnútri značiek nadpisu iné HTML značky.
Vaša prvá vlastná funkcia – vylepšenie spojovníkov
Skutočná sila režimu funkcie spočíva v možnosti vytvárať si vlastné funkcie na ľubovoľné spracovanie textu. Nástroj Vylepšiť interpunkciu v editore necháva jednotlivé spojovníky na pokoji, takže pomocou tejto funkcie ich môžete nahradiť pomlčkami.
Ak chcete vytvoriť novú funkciu, jednoducho kliknite na tlačidlo Vytvoriť/upraviť, vytvorte novú funkciu a skopírujte kód Pythonu uvedený nižšie.
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    return match.group().replace('--', '—').replace('-', '—')
Každá vlastná funkcia Hľadať a nahradiť musí mať jedinečný názov a musí pozostávať z funkcie Pythonu s názvom replace, ktorá prijíma všetky vyššie uvedené argumenty. Zatiaľ sa nebudeme zaoberať všetkými rôznymi argumentmi funkcie replace(). Zamerajte sa len na argument match. Predstavuje zhodu pri spustení hľadania a nahrádzania. Jeho úplná dokumentácia je dostupná tu. match.group() jednoducho vráti všetok zodpovedajúci text a my len nahradíme spojovníky v tomto texte pomlčkami, najprv nahradíme dvojité spojovníky a potom jednoduché spojovníky.
Túto funkciu použite s týmto regulárnym výrazom na hľadanie:
>[^<>]+<
A nahradí všetky spojovníky pomlčkami, ale iba v skutočnom texte, nie vnútri definícií HTML značiek.
Sila režimu funkcie – použitie pravopisného slovníka na opravu nesprávne rozdelených slov
E-knihy vytvorené skenovaním tlačených kníh často obsahujú nesprávne rozdelené slová – slová, ktoré boli na tlačenej strane rozdelené na konci riadka. Napíšeme jednoduchú funkciu, ktorá takéto slová automaticky nájde a opraví.
import regex
from calibre import replace_entities
from calibre import prepare_string_for_xml

def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):

    def replace_word(wmatch):
        # Try to remove the hyphen and replace the words if the resulting
        # hyphen free word is recognized by the dictionary
        without_hyphen = wmatch.group(1) + wmatch.group(2)
        if dictionaries.recognized(without_hyphen):
            return without_hyphen
        return wmatch.group()

    # Search for words split by a hyphen
    text = replace_entities(match.group()[1:-1])  # Handle HTML entities like &
    corrected = regex.sub(r'(\w+)\s*-\s*(\w+)', replace_word, text, flags=regex.VERSION1 | regex.UNICODE)
    return '>%s<' % prepare_string_for_xml(corrected)  # Put back required entities
Túto funkciu použite s rovnakým výrazom na hľadanie ako predtým, konkrétne:
>[^<>]+<
A magicky opraví všetky nesprávne rozdelené slová v texte knihy. Hlavným trikom je použitie jedného z užitočných extra argumentov funkcie replace, dictionaries. Odkazuje na slovníky, ktoré samotný editor používa na kontrolu pravopisu textu v knihe. Táto funkcia vyhľadá slová oddelené spojovníkom, odstráni spojovník a skontroluje, či slovník rozpoznáva zložené slovo; ak áno, pôvodné slová sa nahradia zloženým slovom bez spojovníka.
Upozorňujeme, že jedným obmedzením tejto techniky je, že bude fungovať iba pre jednojazyčné knihy, pretože v predvolenom nastavení dictionaries.recognized() používa hlavný jazyk knihy.
Automatické číslovanie sekcií
Teraz uvidíme niečo trochu odlišné. Predpokladajme, že váš HTML súbor má mnoho sekcií, každú s nadpisom v značke <h2>, ktorá vyzerá ako <h2>Nejaký text</h2>. Môžete vytvoriť vlastnú funkciu, ktorá tieto nadpisy automaticky očísluje po sebe idúcimi číslami sekcií, takže budú vyzerať ako <h2>1. Nejaký text</h2>.
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    section_number = '%d. ' % number
    return match.group(1) + section_number + match.group(2)

# Ensure that when running over multiple files, the files are processed
# in the order in which they appear in the book
replace.file_order = 'spine'
Použite ju s výrazom na hľadanie:
(?s)(<h2[^<>]*>)(.+?</h2>)
Umiestnite kurzor na začiatok súboru a kliknite na Nahradiť všetko.
Táto funkcia používa ďalší z užitočných extra argumentov funkcie replace(): argument number. Pri Nahradiť všetko sa číslo automaticky zvýši pre každú ďalšiu zhodu.
Ďalšou novou funkciou je použitie replace.file_order – nastavenie na 'spine' znamená, že ak sa toto vyhľadávanie spustí na viacerých HTML súboroch, súbory sa spracujú v poradí, v akom sa nachádzajú v knihe. Podrobnosti nájdete v Výber poradia súborov pri spustení na viacerých HTML súboroch.
Automatické vytvorenie obsahu
Nakoniec skúsme niečo trochu ambicióznejšie. Predpokladajme, že vaša kniha má nadpisy v značkách h1 a h2, ktoré vyzerajú ako <h1 id="someid">Nejaký text</h1>. Na základe týchto nadpisov automaticky vygenerujeme HTML obsah. Vytvorte nižšie uvedenú vlastnú funkciu:
from calibre import replace_entities
from calibre.ebooks.oeb.polish.toc import TOC, toc_to_html
from calibre.gui2.tweak_book import current_container
from calibre.ebooks.oeb.base import xml2str

def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    if match is None:
        # All matches found, output the resulting Table of Contents.
        # The argument metadata is the metadata of the book being edited
        if 'toc' in data:
            toc = data['toc']
            root = TOC()
            for (file_name, tag_name, anchor, text) in toc:
                parent = root.children[-1] if tag_name == 'h2' and root.children else root
                parent.add(text, file_name, anchor)
            toc = toc_to_html(root, current_container(), 'toc.html', 'Table of Contents for ' + metadata.title, metadata.language)
            print(xml2str(toc))
        else:
            print('No headings to build ToC from found')
    else:
        # Add an entry corresponding to this match to the Table of Contents
        if 'toc' not in data:
            # The entries are stored in the data object, which will persist
            # for all invocations of this function during a 'Replace All' operation
            data['toc'] = []
        tag_name, anchor, text = match.group(1), replace_entities(match.group(2)), replace_entities(match.group(3))
        data['toc'].append((file_name, tag_name, anchor, text))
        return match.group()  # We don't want to make any actual changes, so return the original matched text

# Ensure that we are called once after the last match is found so we can
# output the ToC
replace.call_after_last_match = True
# Ensure that when running over multiple files, this function is called,
# the files are processed in the order in which they appear in the book
replace.file_order = 'spine'
A použite ju s výrazom na hľadanie:
<(h[12]) [^<>]* id=['"]([^'"]+)['"][^<>]*>([^<>]+)
Spustite vyhľadávanie na Všetky textové súbory a na konci vyhľadávania sa zobrazí okno s „Ladiacim výstupom z vašej funkcie“, ktoré bude obsahovať HTML obsah pripravený na vloženie do toc.html.
Funkcia vyššie je bohato komentovaná, takže by mala byť ľahko pochopiteľná. Kľúčovou novou funkciou je použitie ďalšieho užitočného extra argumentu funkcie replace(), objektu data. Objekt data je slovník Pythonu, ktorý pretrváva medzi všetkými po sebe idúcimi volaniami replace() počas jednej operácie Nahradiť všetko.
Ďalšou novou funkciou je použitie call_after_last_match – nastavenie na True vo funkcii replace() znamená, že editor zavolá replace() ešte raz po nájdení všetkých zhôd. Pri tomto extra volaní bude objekt match None.
Toto bola len ukážka, ktorá vám mala predviesť silu režimu funkcie. Ak by ste naozaj potrebovali vygenerovať obsah z nadpisov vo svojej knihe, radšej by ste mali použiť špecializovaný nástroj Obsah v Nástroje → Obsah.
API pre režim funkcie
Všetky funkcie režimu funkcie musia byť funkcie Pythonu s názvom replace s nasledujúcou signatúrou:
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    return a_string
Pri spustení hľadania a nahrádzania sa pre každú nájdenú zhodu zavolá funkcia replace(), ktorá musí vrátiť náhradný reťazec pre túto zhodu. Ak sa nemá vykonať žiadna náhrada, mala by vrátiť match.group(), čo je pôvodný reťazec. Jednotlivé argumenty funkcie replace() sú zdokumentované nižšie.
Argument match
Argument match predstavuje aktuálne nájdenú zhodu. Je to objekt Match v Pythone. Jeho najužitočnejšou metódou je group(), ktorú možno použiť na získanie zodpovedajúceho textu pre jednotlivé zachytávacie skupiny v regulárnom výraze vyhľadávania.
Argument number
Argument number je číslo aktuálnej zhody. Pri spustení Nahradiť všetko každá ďalšia zhoda spôsobí, že sa replace() zavolá s rastúcim číslom. Prvá zhoda má číslo 1.
Argument file_name
Toto je názov súboru, v ktorom bola nájdená aktuálna zhoda. Pri vyhľadávaní v označenom texte je file_name prázdny. file_name je v kanonickej podobe, cesta relatívna ku koreňu knihy, pričom ako oddeľovač cesty sa používa /.
Argument metadata
Predstavuje metadáta aktuálnej knihy, ako sú názov, autori, jazyk atď. Je to objekt triedy calibre.ebooks.metadata.book.base.Metadata. Medzi užitočné atribúty patria title, authors (zoznam autorov) a language (kód jazyka).
Argument dictionaries
Predstavuje kolekciu slovníkov používaných na kontrolu pravopisu aktuálnej knihy. Jeho najužitočnejšou metódou je dictionaries.recognized(word), ktorá vráti True, ak je zadané slovo rozpoznané slovníkom pre jazyk aktuálnej knihy.
Argument data
Toto je jednoduchý slovník Pythonu. Pri spustení Nahradiť všetko každá ďalšia zhoda spôsobí, že sa replace() zavolá s rovnakým slovníkom ako data. Môžete ho teda použiť na ukladanie ľubovoľných údajov medzi volaniami replace() počas operácie Nahradiť všetko.
Argument functions
Argument functions vám poskytuje prístup ku všetkým ostatným používateľsky definovaným funkciám. To je užitočné na opätovné použitie kódu. Môžete definovať pomocné funkcie na jednom mieste a znova ich použiť vo všetkých ostatných funkciách. Predpokladajme napríklad, že vytvoríte funkciu s názvom My Function takto:
def utility():
   # do something

def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    ...
Potom v inej funkcii môžete pristupovať k funkcii utility() takto:
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    utility = functions['My Function']['utility']
    ...
Objekt functions môžete tiež použiť na ukladanie trvalých údajov, ktoré môžu znova použiť iné funkcie. Môžete napríklad mať jednu funkciu, ktorá pri spustení s Nahradiť všetko zhromažďuje nejaké údaje, a inú funkciu, ktorá ich použije pri neskoršom spustení. Zvážte nasledujúce dve funkcie:
# Function One
persistent_data = {}

def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    ...
    persistent_data['something'] = 'some data'

# Function Two
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    persistent_data = functions['Function One']['persistent_data']
    ...
Ladenie vašich funkcií
Funkcie, ktoré vytvoríte, môžete ladiť pomocou štandardnej funkcie print() z Pythonu. Výstup funkcie print sa zobrazí vo vyskakovacom okne po dokončení hľadania a nahrádzania. Príklad použitia print() na výstup celého obsahu ste videli vyššie.
Výber poradia súborov pri spustení na viacerých HTML súboroch
Pri spustení Nahradiť všetko na viacerých HTML súboroch závisí poradie, v ktorom sa súbory spracúvajú, od toho, ktoré súbory máte otvorené na úpravu. Vyhľadávanie môžete prinútiť spracovať súbory v poradí, v akom sa nachádzajú, nastavením atribútu file_order vo vašej funkcii takto:
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    ...

replace.file_order = 'spine'
file_order akceptuje dve hodnoty, spine a spine-reverse, ktoré spôsobia, že vyhľadávanie spracuje viacero súborov v poradí, v akom sa nachádzajú v knihe, buď dopredu, alebo dozadu.
Zavolanie funkcie ešte raz po nájdení poslednej zhody
Niekedy, ako v príklade s automatickým generovaním obsahu vyššie, je užitočné mať funkciu zavolanú ešte raz po nájdení poslednej zhody. Môžete to urobiť nastavením atribútu call_after_last_match vo vašej funkcii takto:
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    ...

replace.call_after_last_match = True
Pripojenie výstupu funkcie k označenému textu
Pri spustení hľadania a nahrádzania na označenom texte je niekedy užitočné pripojiť nejaký text na koniec označeného textu. Môžete to urobiť nastavením atribútu append_final_output_to_marked vo vašej funkcii (všimnite si, že musíte nastaviť aj call_after_last_match) takto:
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    ...
    return 'some text to append'

replace.call_after_last_match = True
replace.append_final_output_to_marked = True
Potlačenie dialógového okna s výsledkami pri vyhľadávaní v označenom texte
Dialógové okno s výsledkami (ktoré môže spomaliť opakované používanie hľadania a nahrádzania na mnohých blokoch textu) môžete tiež potlačiť nastavením atribútu suppress_result_dialog vo vašej funkcii takto:
def replace(match, number, file_name, metadata, dictionaries, data, functions, *args, **kwargs):
    ...

replace.suppress_result_dialog = True
Ďalšie príklady
Ďalšie užitočné príklady, ktorými prispeli používatelia calibre, nájdete na fóre editora e-kníh calibre.